AgentX 面试准备文档(ms_ready)
依据两轮面试反馈(综合 75 / 84,结论:通过 / 高潜)提炼可打优势点,并对照
agentx仓库真实模块落点。目标:进面试时用项目事实讲清「我做过什么、为什么这样设计、边界在哪」。
0. 反馈里真正加分的信号
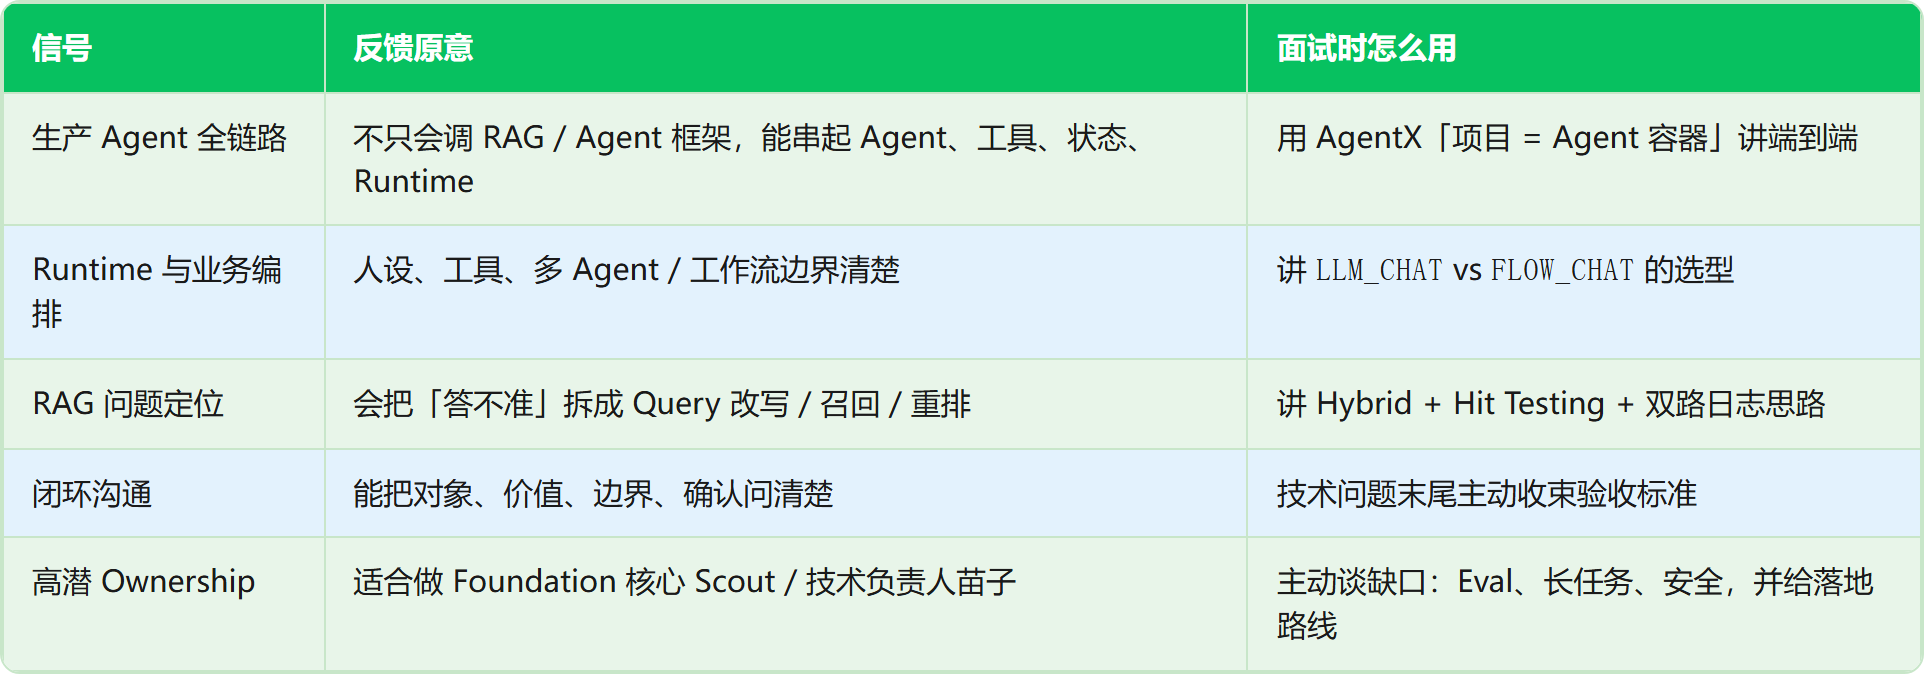
刻意少吹、主动补的短板(面试官已点名): Eval / Durable Execution、AI Foundation 独立 Ownership、MCP 安全深度。策略:承认现状 → 用 AgentX 现有能力映射 → 给出可落地的补齐方案。
1. 三个能体现自身优点的面试话题(主打)
以下三个话题对应反馈里最硬的优势,且都能在 AgentX 代码里指到模块。
话题 A · 生产级 Agent Runtime 与业务编排
一句话定位: 我能把「数字员工」从产品对象拆到运行时边界,而不是只会堆 Prompt。
AgentX 事实锚点
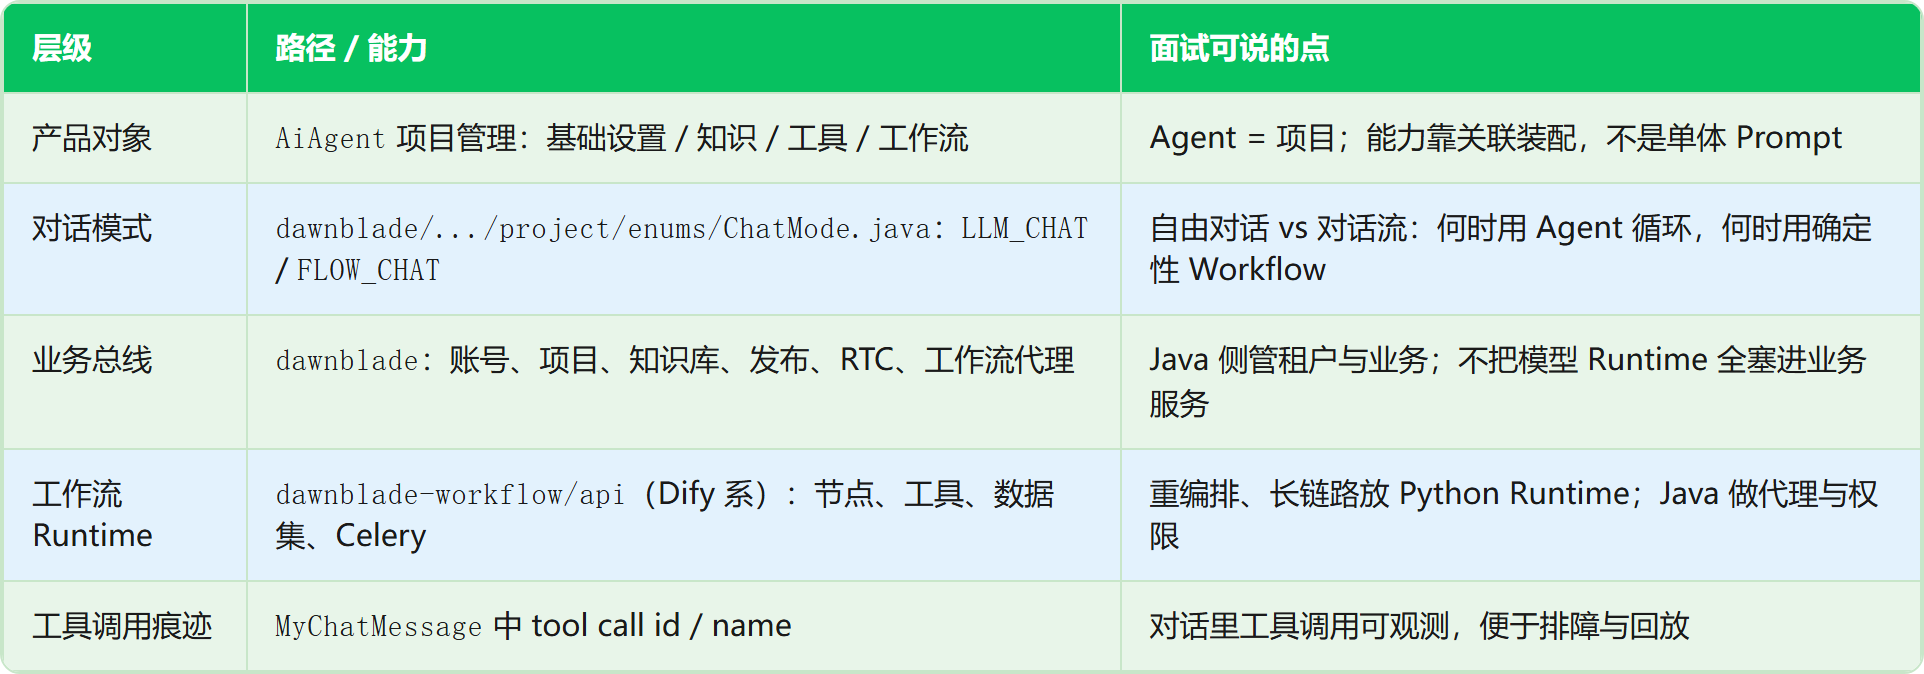
建议口述结构(2~3 分钟)
- 问题: 企业数字员工既要「能聊」,又要「能办事、能发布、能计费」。
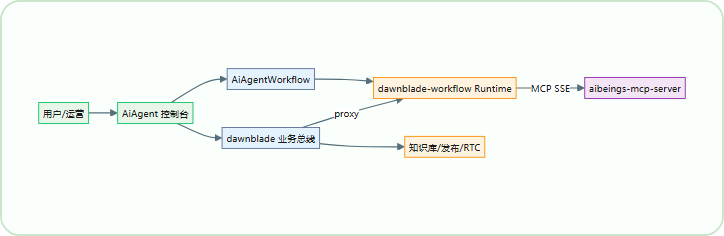
- 拆分: 控制台(
AiAgent)→ 业务 API(dawnblade)→ 工作流 Runtime(dawnblade-workflow)→ MCP 工具(aibeings-mcp-server)。 - 关键选型:
LLM_CHAT绑知识+工具+工作流;FLOW_CHAT以对话流为主,适合流程更确定的场景。 - 对应业界概念: Sub-Agent / HandOff ≈ 项目内关联工作流或工具链;状态 ≈ 会话日志 + 工作流执行态,而不是口头「有状态」。
- 边界诚实: 当前更偏「产品化 Agent 平台」,不是完整 AI Foundation(记忆层级、多租户 Agent OS 仍可加强)。
可能追问与答法
- Q: HandOff 你们怎么做?
A: 产品层用「项目关联工作流 / 工具」表达职责移交;Runtime 层由 workflow 节点与 tool call 承接。若要做显式 Agent-to-Agent HandOff,会在会话态加路由策略与角色边界,而不是只改 Prompt。 - Q: 为什么 Java + Python 双后端?
A: 业务一致性、权限、渠道发布适合 Spring;模型供应商、RAG、工作流图执行适合 Python Runtime。dawnblade对 workflow 做 proxy,避免前端直连两套鉴权。
话题 B · RAG:把「答不准」定位到链路,而不是怪模型
一句话定位: 我会用检索链路拆问题——Query、召回策略、Hybrid、Rerank、命中测试——这是反馈里明确加分的点。
AgentX 事实锚点
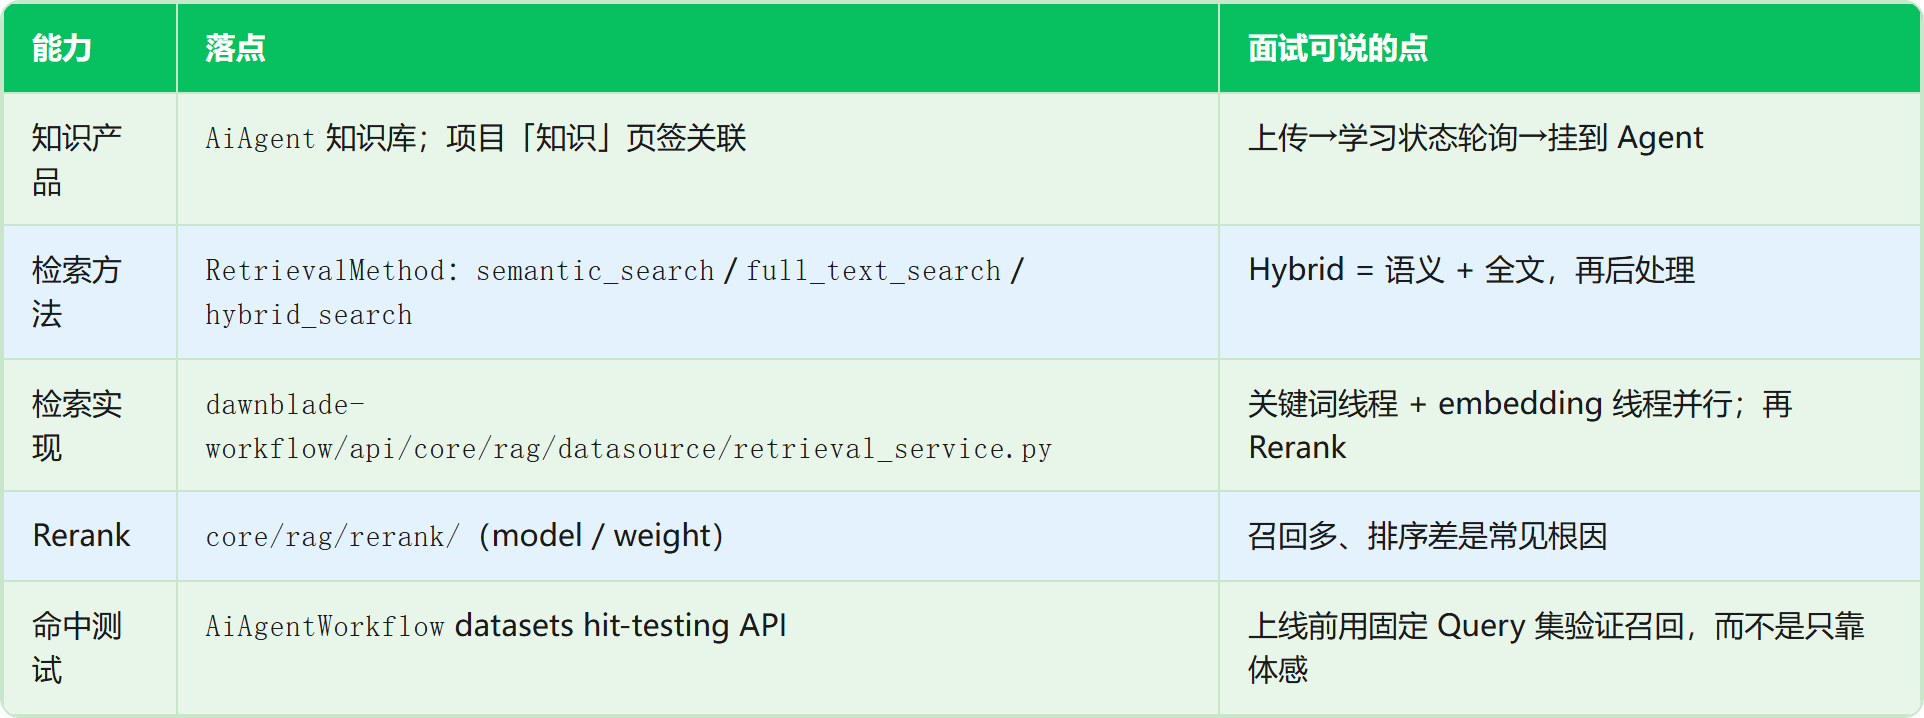
建议口述:一次真实排障故事模板
- 现象:Agent 答非所问 / 漏答专有名词。
- 假设分流:
- Query 与文档用语不一致 → 需要 Rewrite Query,并保留「原始 Query + Rewrite Query」双路召回对比。
- 纯向量漏关键词 → 开hybrid_search。
- 召回对但排序乱 → 查 Rerank 是否启用、模型是否匹配语种。
- 切片过碎/过粗 → 回看 index processor / 分段策略。 - 验证:Hit Testing + 日志里同时打原始/改写 Query 与 top_k 片段。
- 结论:多数「模型不行」其实是检索配置与评测缺失。
对应反馈原话怎么接
「能把问题定位到 Rewrite Query 对原文术语语义丢失,并增加原始 Query 与 Rewrite Query 双路召回」
面试时直接说:AgentX 已具备 Hybrid / Rerank / Hit Testing;若我负责下一迭代,会把 Query Rewrite 双路 和 离线 Eval 集(命中率 / 拒答率) 做成平台能力,而不是个案脚本。
可能追问
- Q: Hybrid 如何融合?
A: 并行 keyword + semantic,再经DataPostProcessor/ Rerank(model 或 weight)。权重与 top_k、score_threshold 要按语料调,不能默认抄一套。 - Q: 和 BM25 / RRF 的关系?
A: 全文/关键词路近似稀疏检索;融合可用加权或 Rerank 模型统一打分。重点是可观测与可回归,不是名词堆砌。
话题 C · MCP 工具链 + 闭环沟通(技术硬能力 × 协作软能力)
一句话定位: 我既能把外部能力收成可调用工具,也能把需求收到可验收闭环——这是第二轮「高潜」的核心加分项。
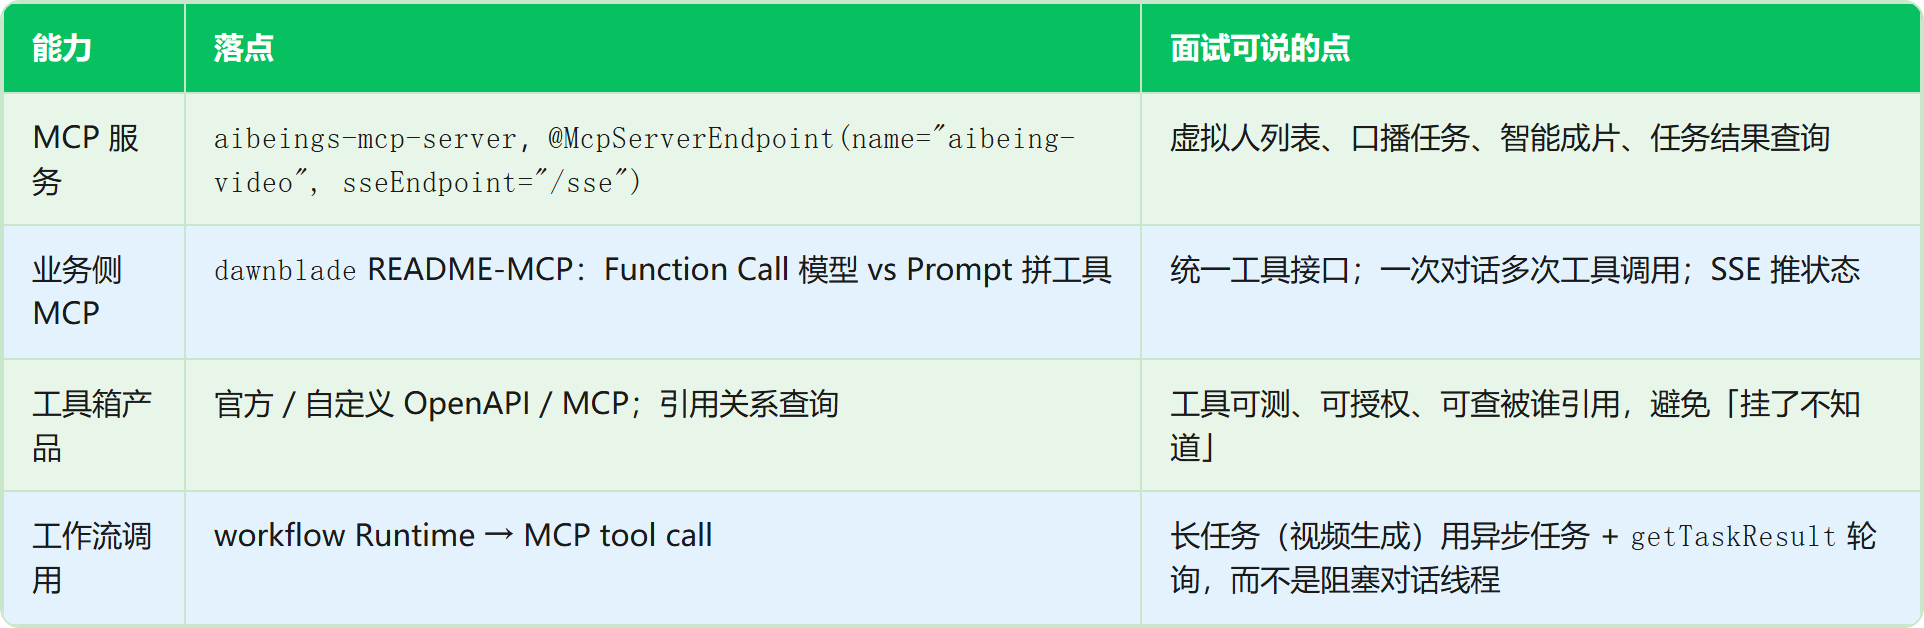
AgentX 事实锚点(硬)
建议口述结构
- 协议价值: MCP 把「模型能用的能力」标准化;我们不是只接一个 HTTP,而是 schema、鉴权、测试、引用、运行时事件一条链。
- 双适配: 有 FC 的模型走 Function Call;无 FC 的走 Prompt 工具描述——同一套工具注册表。
- 异步现实: 视频生成是长耗时,必须任务化 + 结果查询;这和面试官关心的 Durable Execution 同一类问题,只是我们当前用任务表/轮询,尚未上 Temporal。
- 软能力接法(闭环): 对接业务时固定四问——对象是谁、价值指标是什么、边界/不做清单、验收怎么确认——再进入技术方案。
主动补短板(加分话术)
反馈说 MCP 安全与 Eval/Durable 仍浅。我的补齐计划:
1)MCP:工具级鉴权、参数白名单、Prompt Injection 隔离(工具结果不可直接当系统指令)、审计日志。
2)Durable:对视频/工作流长任务抽象「可恢复执行」——至少做到状态机 + 幂等 + 超时重试;评估 Temporal 是否值得引入。
3)Eval:对话与 RAG 各建黄金集,CI 跑 hit-rate / 工具选择正确率,而不是只看 demo。
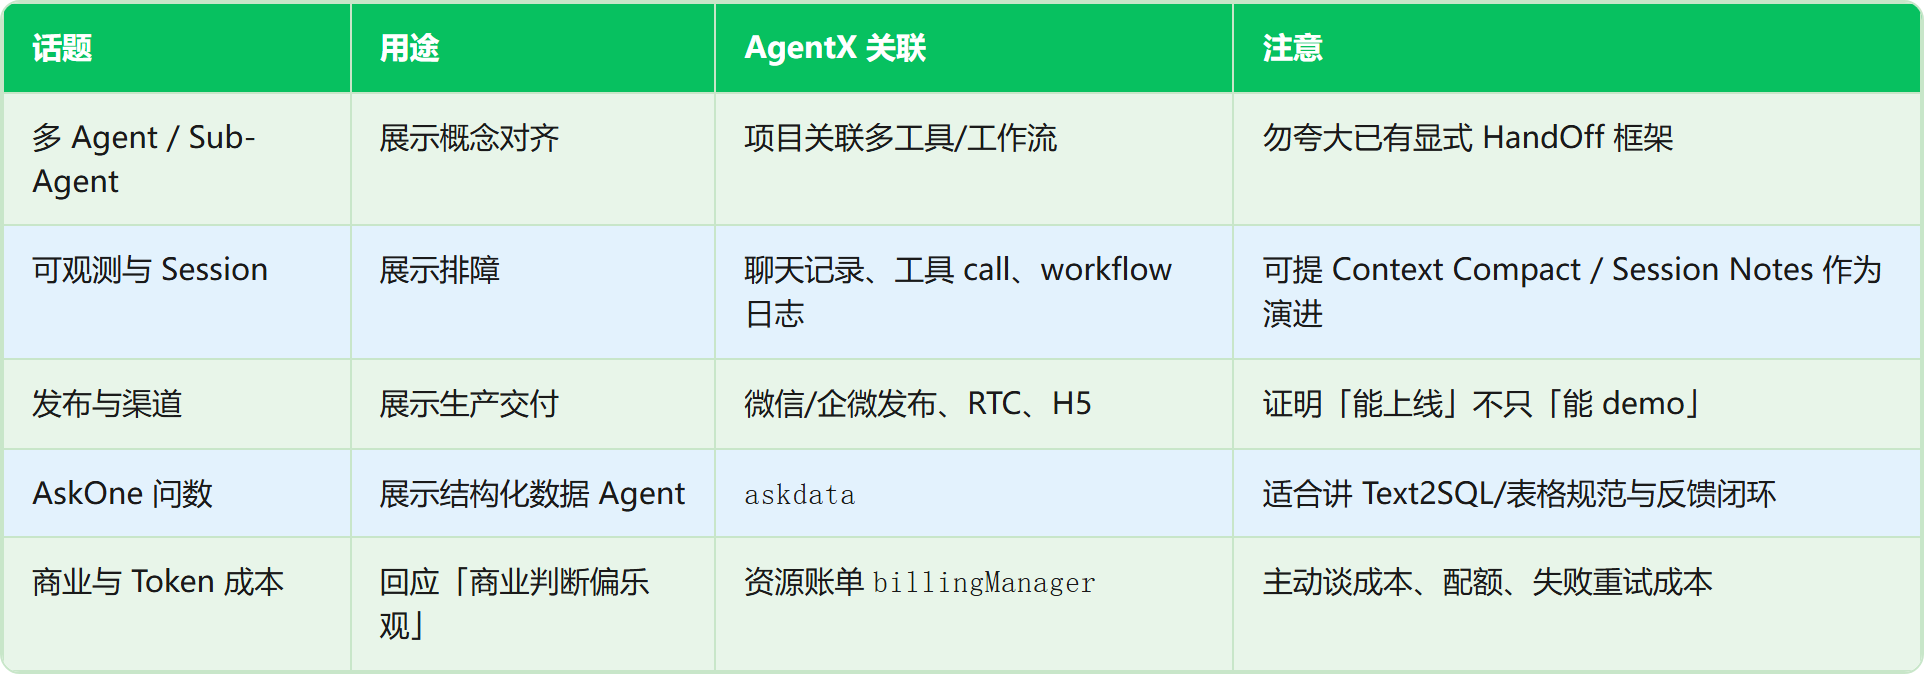
2. 从反馈提炼的其他话题库(备用,不主打)
3. 项目一张图(开场 60 秒版)
开场稿:
AgentX 是企业数字员工交付仓:三个前端(企业台 / 教育台 / 工作流台)+ 三个后端(Java 业务
dawnblade、Python 工作流 Runtime、MCP 视频工具服务)。我负责/熟悉的主线是:项目如何装配知识、工具与工作流,并在 Runtime 上跑通对话与长任务。和纯 Agent 框架 demo 的差别是,这里有租户、发布、RTC、计费和可运维的工具链。
成功标准(自测): 听的人能复述出「业务总线 vs Runtime vs MCP」三层,以及 Agent 项目的四个页签。
4. 面试官可能压的短板:标准应答卡
4.1 AI Foundation 不完整
答: 当前 AgentX 强在应用与交付层(项目、知识、工具、工作流、渠道)。Foundation 层(统一记忆、Agent OS、评测与治理)确实更薄。若负责 Scout,我会先定最小 Foundation:会话记忆模型、工具治理、Eval 流水线、长任务执行器四块,用现有模块长出来,而不是推倒重写。
4.2 Eval / Durable Execution 被软化
答: 现有 Hit Testing、运行日志、异步任务结果查询是起点,但还不是 Benchmark 与 Durable Workflow。补齐路径:黄金集 → 回归门槛 → 长任务状态机(幂等/重试/补偿)→ 再评估 Temporal。
4.3 MCP 安全
答: 生产上要把「工具结果」与「系统 Prompt」隔离;按租户鉴权;危险工具二次确认;全链路审计。AgentX 已有工具测试与引用查询,安全策略应产品化进工具箱,而不是各业务私自拼。
5. 临场清单(进门前 10 分钟)
- 能徒手画出:控制台 → dawnblade → workflow → MCP。
- 能解释
LLM_CHAT/FLOW_CHAT各适合什么。 - 能讲一次 RAG 排障:Hybrid + Rerank + Hit Testing +(规划中的)Rewrite 双路。
- 能讲 MCP:SSE、
aibeing-video四个工具、FC vs Prompt 双适配。 - 准备一个「闭环沟通」例子:你如何把模糊需求收到验收标准。
- 主动抛一个 30 天改进提案:Eval 黄金集 + MCP 安全基线 + 长任务状态机。
6. 三个主话题的「金句」备忘
- Runtime:「我们把 Agent 当成可装配的产品对象,Runtime 边界按业务一致性拆分,而不是一个大 Prompt 服务。」
- RAG:「答不准先查检索链路;Hybrid 解决漏召回,Rerank 解决乱序,Hit Testing 解决不可回归。」
- MCP + 闭环:「工具要可注册、可测、可审计;需求要有对象、指标、边界、验收——技术和协作是同一条闭环。」