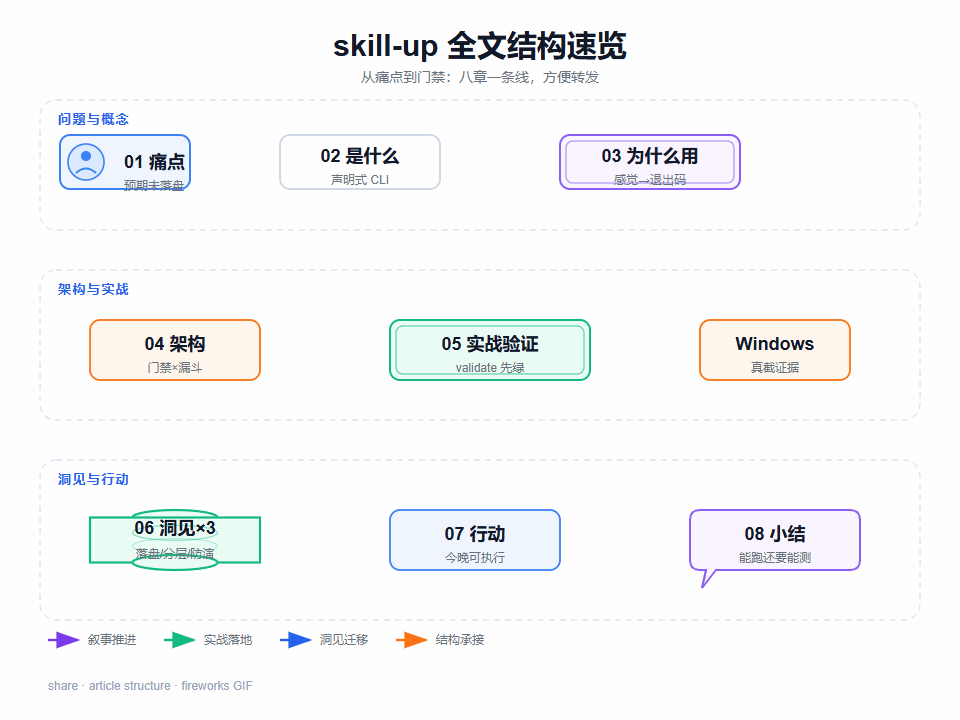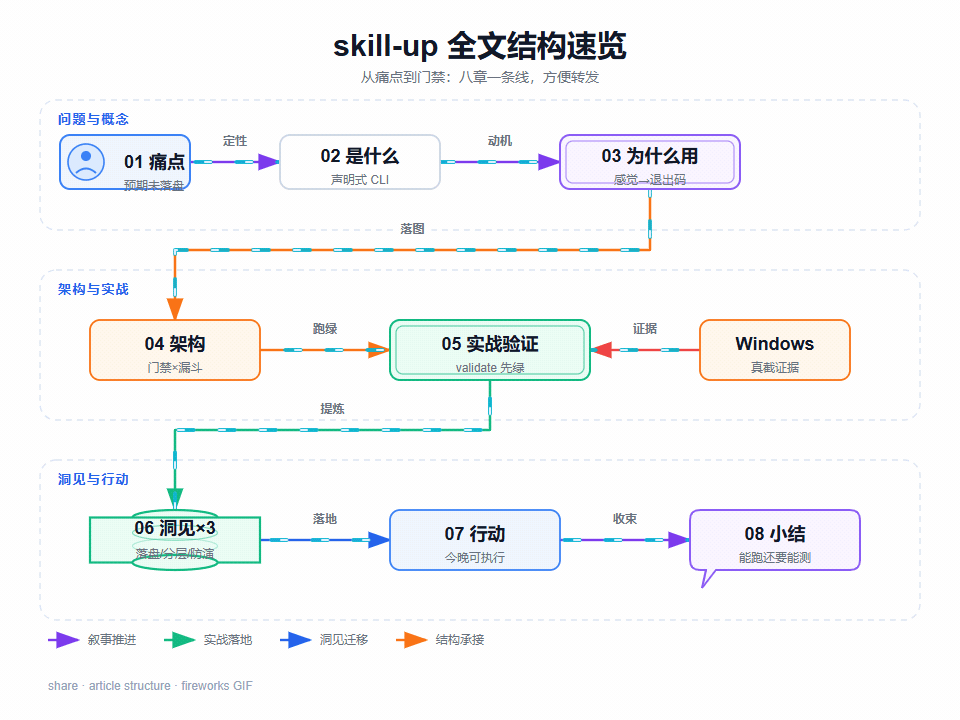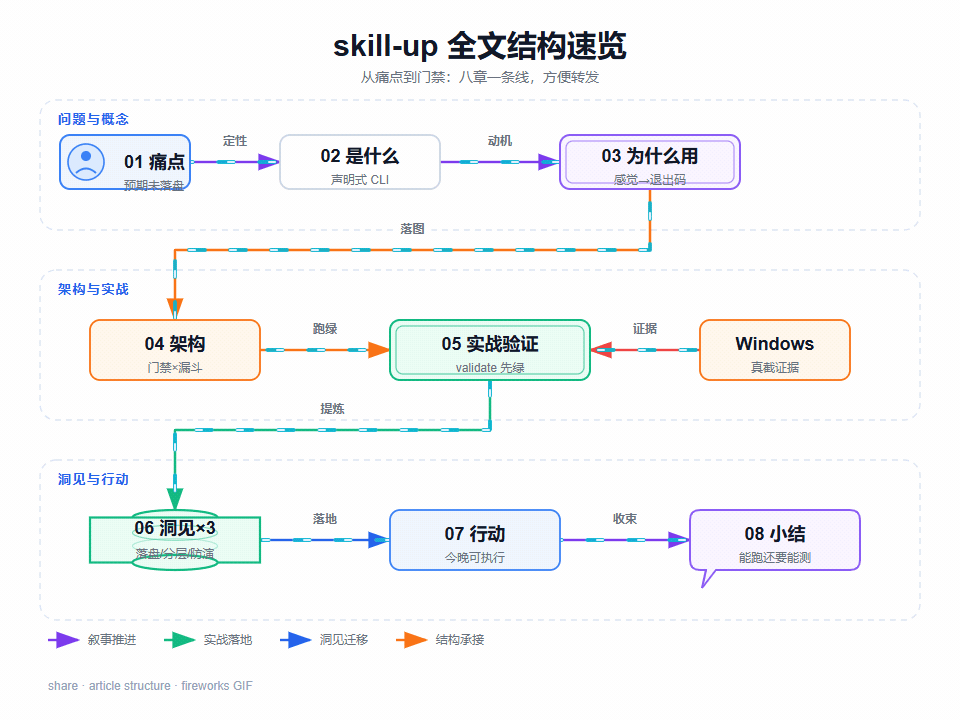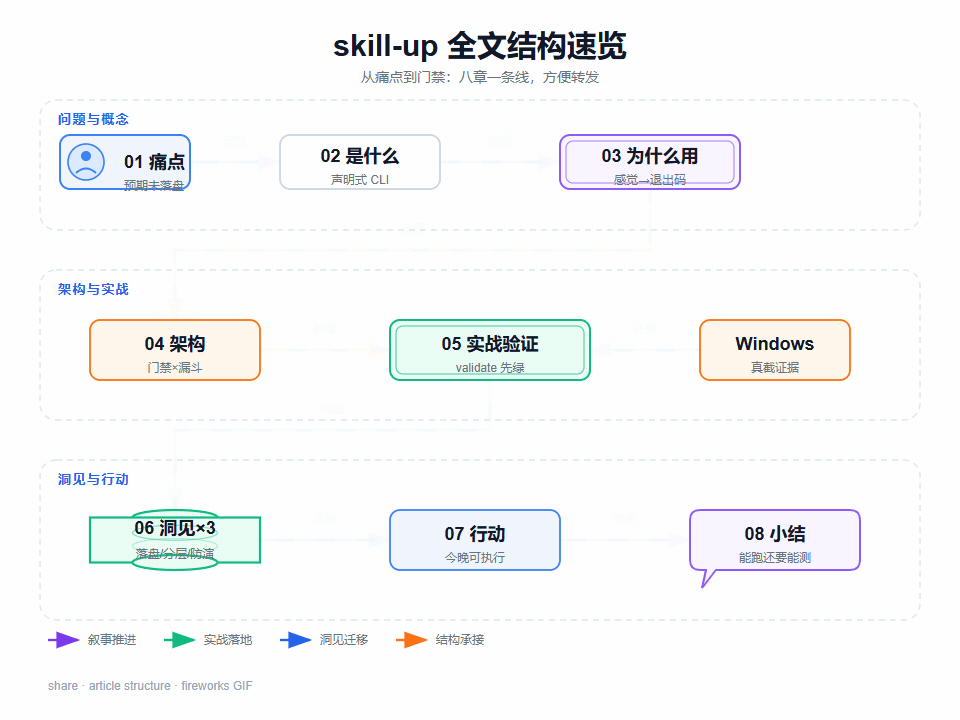
Skill 写得出,测不住?用 skill-up 把「好不好用」钉死
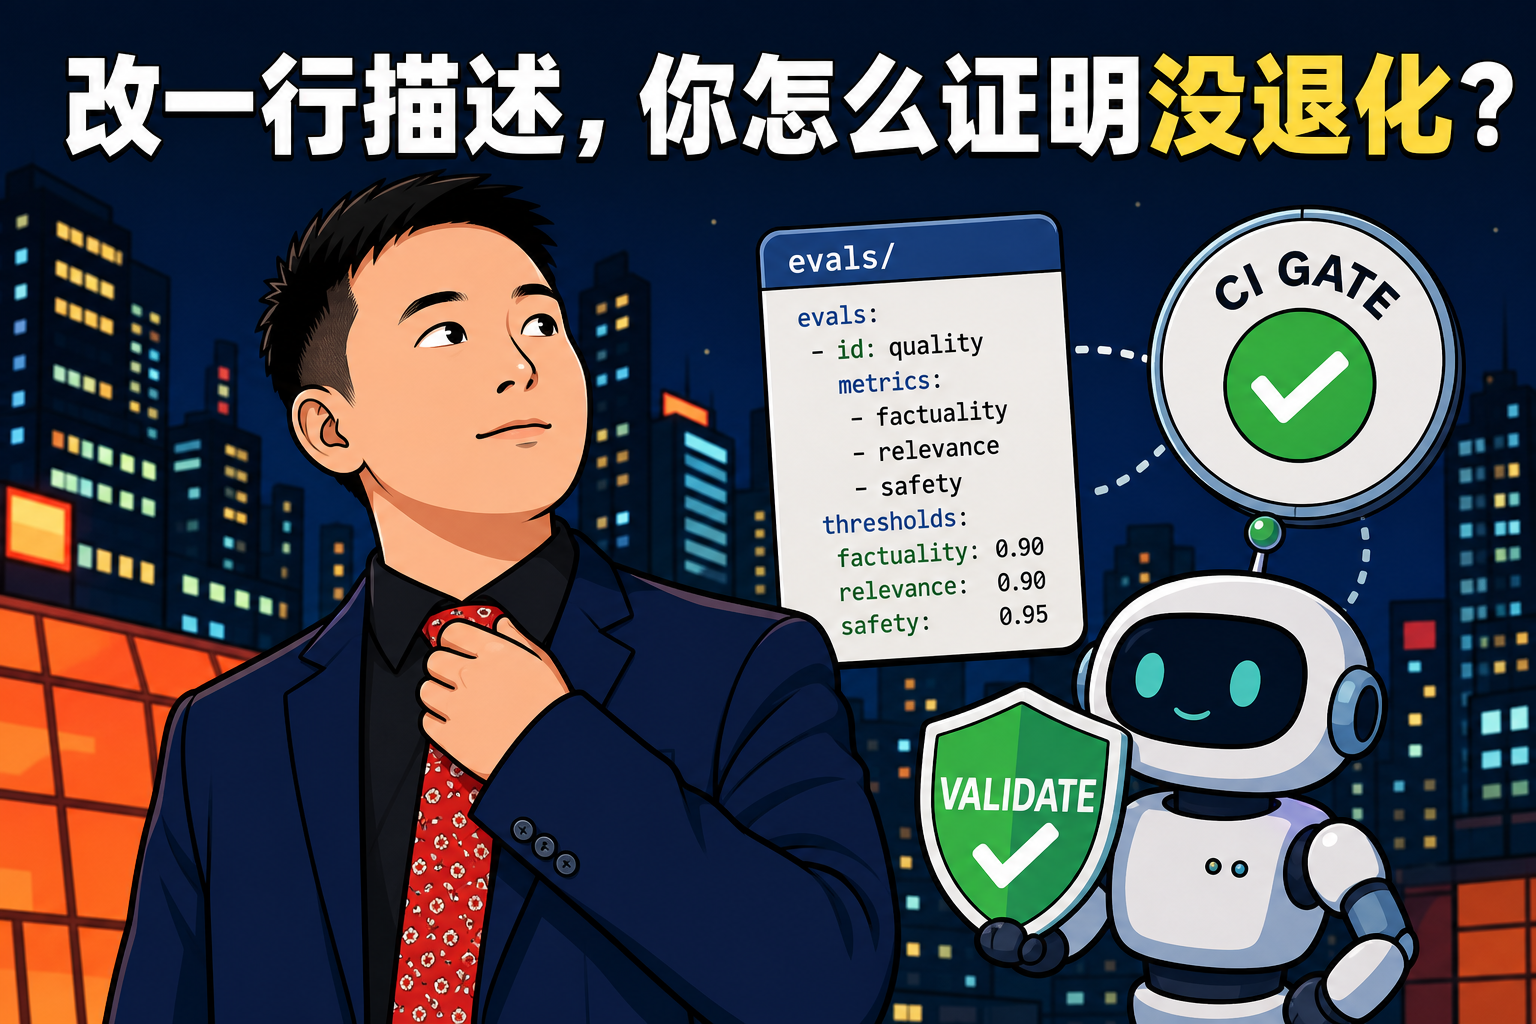
上周五,同事为了「写得更友好」,改了发布计划 Skill 的说明。
本地聊两轮,感觉还行,合进主干。
周一业务方反馈:同样的输入,工具调用没了,输出退化成一段正确的废话。
复盘会上没人说得出「哪条预期被改坏了」——预期从来只活在作者脑子里。
我是老李,AI 时代的互联网架构师。日常一半时间写方案,一半时间擦这类「看起来能跑、线上却翻车」的屁股。
先抛问题:改了一行 Skill 描述,你怎么证明它没有退化?
场景锚点:改描述 → 静默退化 → 复盘说不清预期。本文用本机 Windows 实跑,把预期钉成可 diff、可回放的门禁。
第二幕更糟:有人提议换引擎再试。A 好好的,B 全变样。两人各截几张图、各写主观结论,卡片停在「待评估」。
第三幕在评测脚本:本地一套、CI 一套,字段名都不统一。作者休假,新人不敢动——怕动完没人知道「绿」代表什么。
我不卖焦虑,只卖可复现。下面用阿里开源的 skill-up(本机 v0.7.0,Windows 实跑)。手册:alibaba.github.io/skill-up/zh
01、痛点:Skill 缺的是可回放的预期
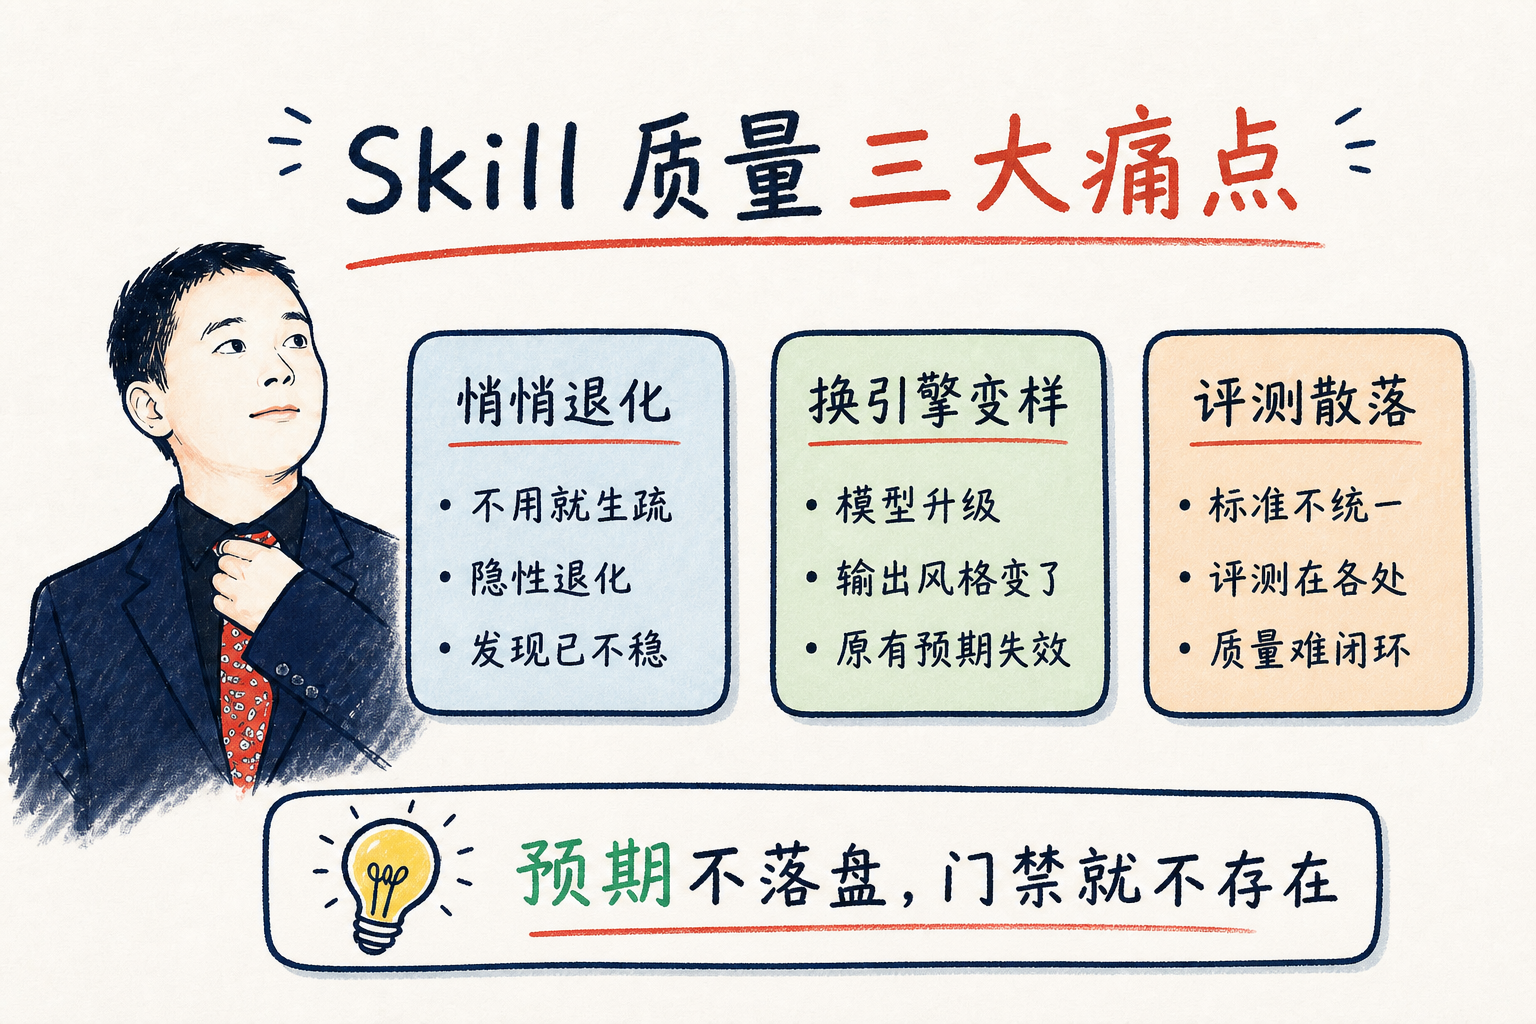
场景·悄悄退化: 发布计划 Skill 改了一句语气,合并没人拦。用户路径上「必须调日历工具」的行为没了——评审看的是文案,不是预期。
场景·换引擎变样: 引擎 A 输出结构稳定,换引擎 B 全变。想系统对比,只能手工点、手工记,最后不了了之。
场景·评测散落: 笔记本脚本和流水线脚本各写各的。作者休假,评测成展品:能跑,没人敢改。
老李的硬判断:说不清「哪条用例守哪条预期」,这套 Skill 迟早在一次「小改描述」里翻车。根因不是模型突然变笨,是预期从未落成可 diff 的文本。文本不落盘,门禁就不存在。
02、是什么:声明式评测,不是聊天自评
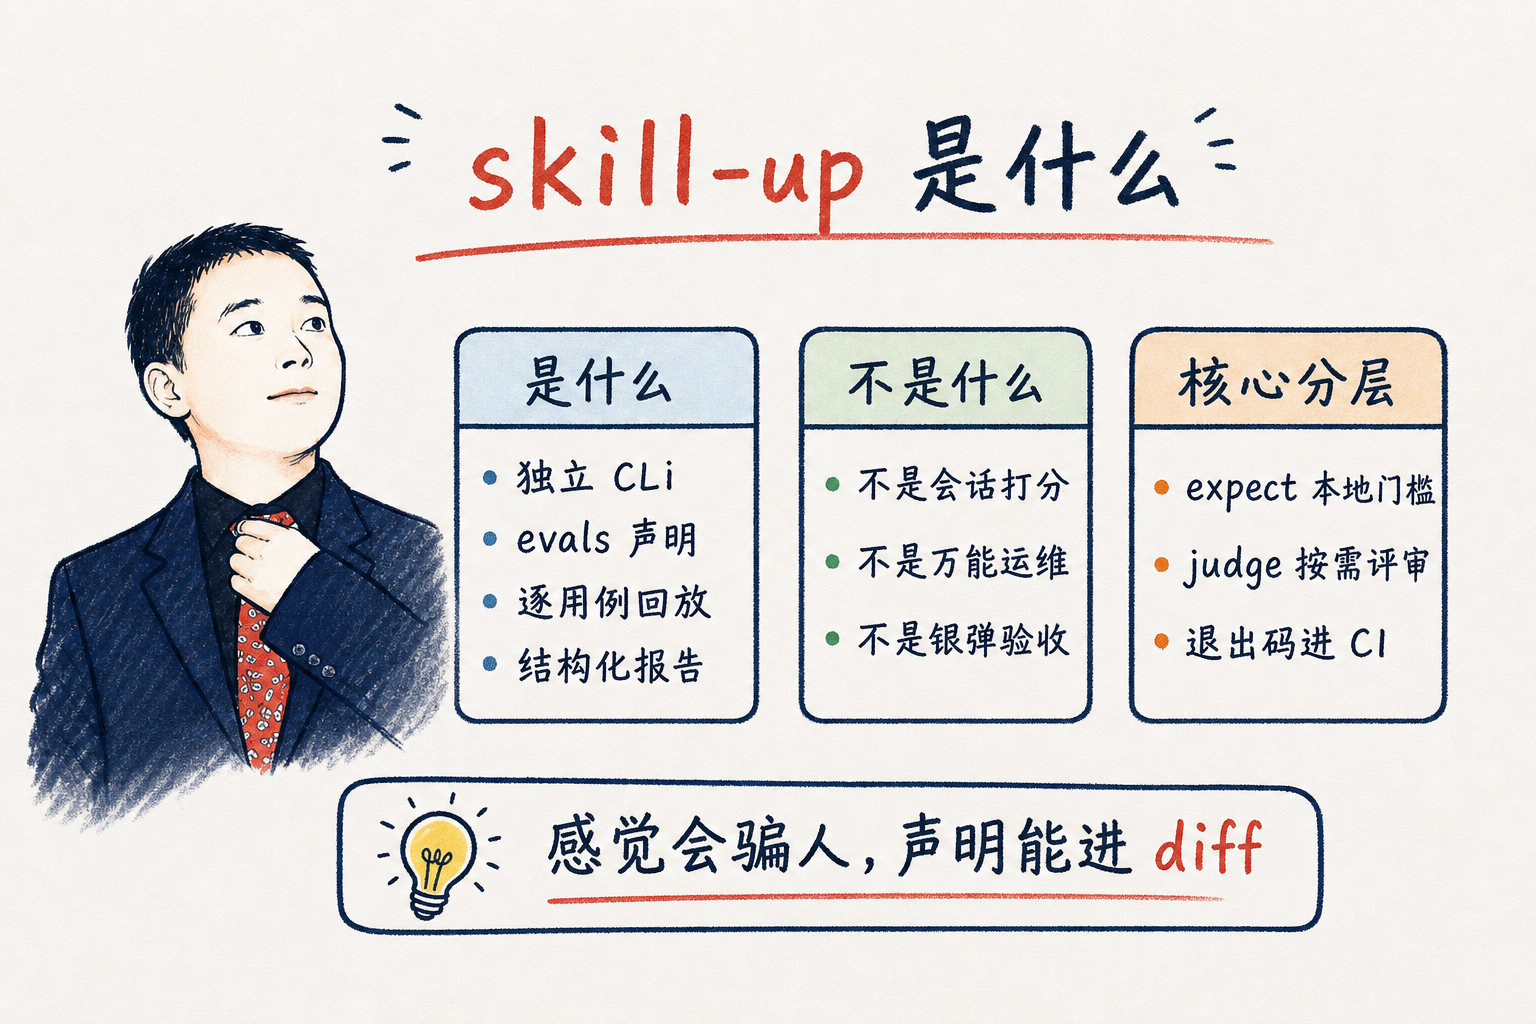
还是那个「改描述」场景:你要的不是再开一个聊天窗口问「感觉怎么样」,而是把「必须包含关键片段」「必须调某工具」写进 evals/cases/*.yaml,用命令回放。感觉会骗人;声明不会——至少它能进 diff。
skill-up 是面向 Agent Skill 的声明式评测 CLI:目录里放 evals/eval.yaml 与用例,声明环境、引擎、判定;一条命令跑完给报告。你可以把它想成「给 Skill 用的单测编排器」:装 Skill、调引擎、跑断言、吐退出码。
它不是模型自评会话,也不是替你准备镜像、标准答案仓和 API Key 的运维机器人,更不是装上就能替代所有人工验收的银弹。适用:多人改 Skill、准备进 CI、要跨引擎对齐。只想随口问问手感——聊天窗口就够了,别浪费框架。
老李常提醒:别把声明式评测理解成「又多写一堆 YAML」。麻烦的是没有 YAML 时,每次回归都要从头口述预期。YAML 是一次性成本;口述是无限循环成本。
03、为什么用:把感觉变成退出码
回到周五那次改动:若预期在 YAML 里,合并请求会直接露出「删掉了 must_contain / 改掉了工具断言」。评审不用靠回忆「上周那版好像会调工具」。
你真正要的三件事:
- 改描述前有人拦——预期可 diff,评审不用靠回忆。
- 本地与 CI 同一套语义——别再维护两套脚本互相打架。
- 失败分得清——先 validate 抓声明错误,再 run 抓行为问题。
这三件事对应三个失败模式:拦不住的合入、对不齐的环境、分不清的锅。skill-up 不保证模型永远稳,它保证争论发生在声明层,而不是情绪层。
不做的代价:线上报障、跨引擎扯皮、新人不敢动评测。做了的收益:退出码进门禁,HTML 报告能甩链接——口头过了不算过,退出码为 0 才算过。
老李只信能复现的东西。下面用本机 v0.7.0 把「声明可验证」跑绿;完整 run 仍取决于引擎与凭据——边界写清楚,才是对读者负责。
04、架构:业务门禁 × 技术漏斗
场景映射很直接:业务上「改 SKILL.md 要过质量闸」;技术上「声明 → validate → run → 判定 → 产物」。同一条故事线,两张视角。
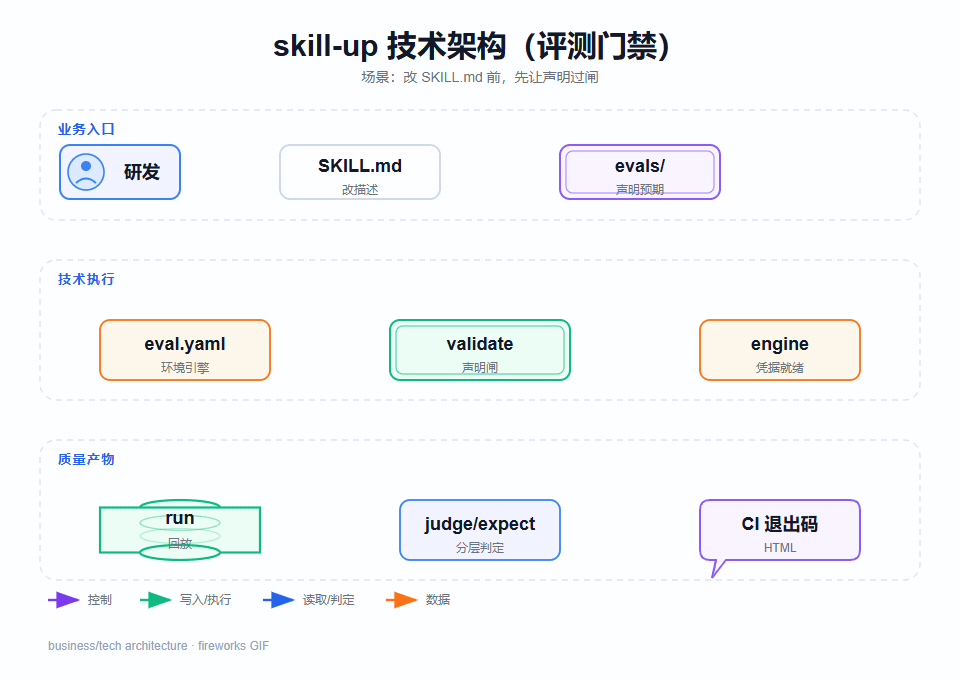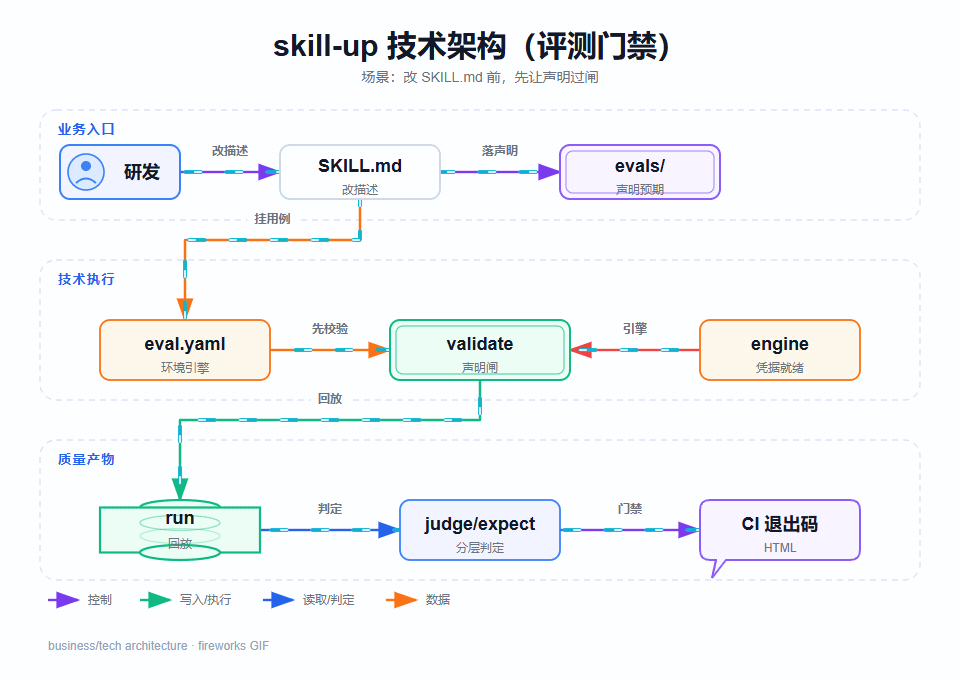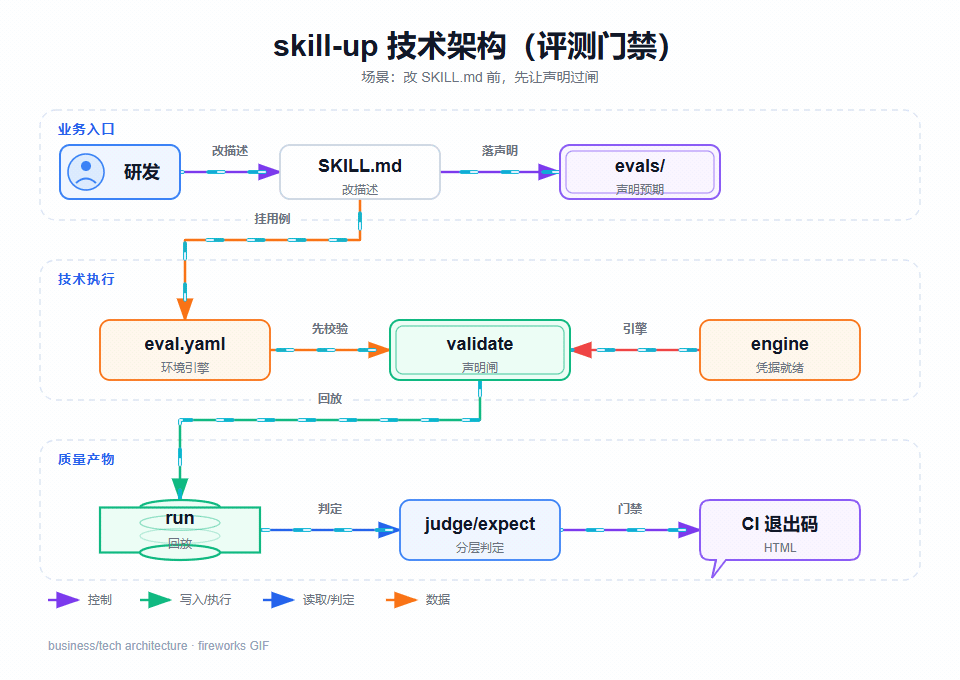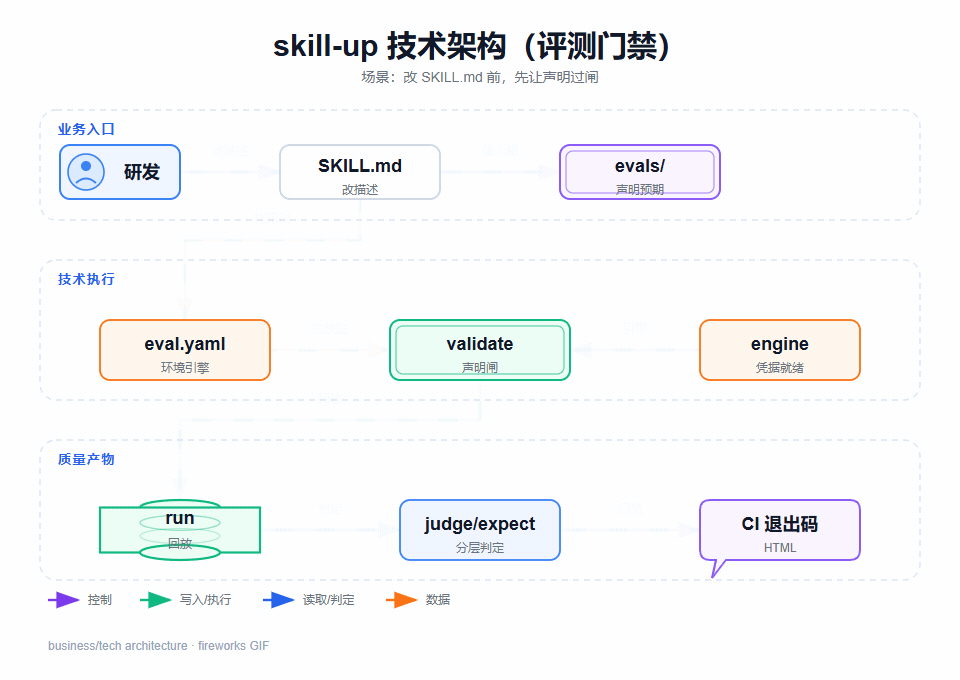
四层怎么对应场景:
- 声明层:
eval.yaml+cases/*.yaml,人能读、Git 能 diff——对应「预期从脑子搬到仓库」。 - 执行层:先 validate 再 run——对应「先抓写飘的 YAML,再烧引擎」。
- 判定层:expect 本地门槛 + judge 按需语义——对应「确定性先过,模糊性后审」。
- 产物层:HTML / JUnit + 退出码——对应「门禁可自动化,不是安慰剂」。
业务架构看「谁在什么时候被拦住」;技术架构看「哪一层把失败分类」。两者对上了,复盘会才不会变成互相甩锅。
05、实战验证:Windows 上把声明跑绿
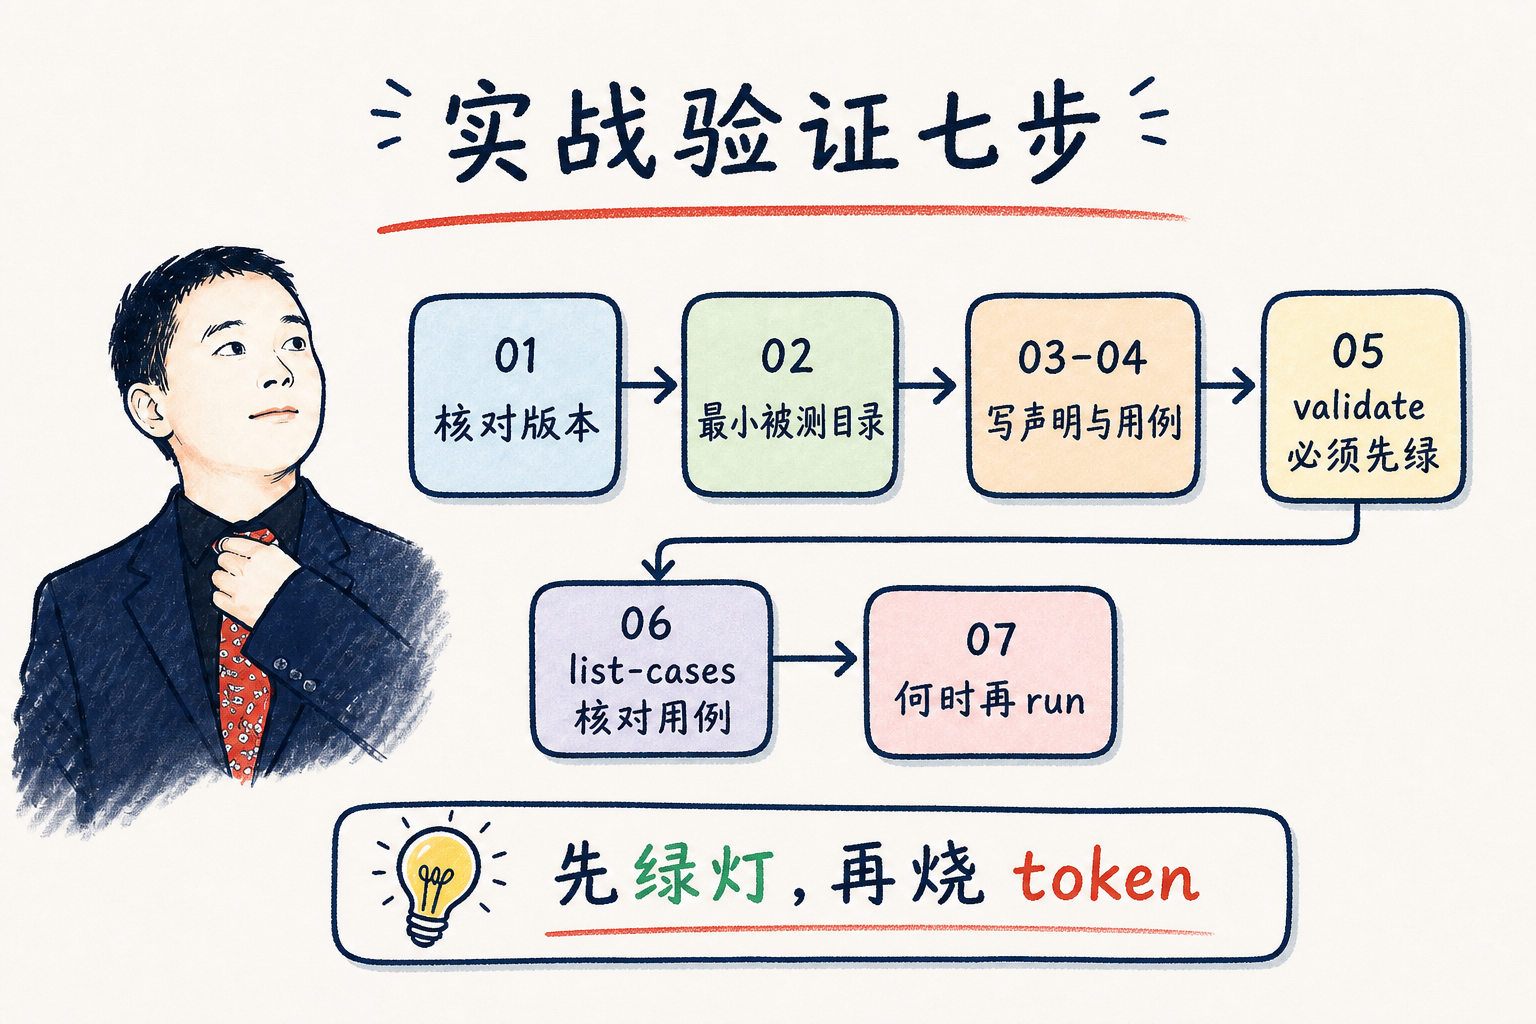
场景目标:在合入那次「友好措辞」改动前,先有一盏本地绿灯证明声明仍可读、用例仍在。以下均在 Windows 本机执行(skill-up v0.7.0),命令真实跑过,截图来自本机命令窗(已去掉桌面杂景)。
01 核对版本
从 Releases 取 Windows amd64 包,解压后:
.\skill-up.exe --version
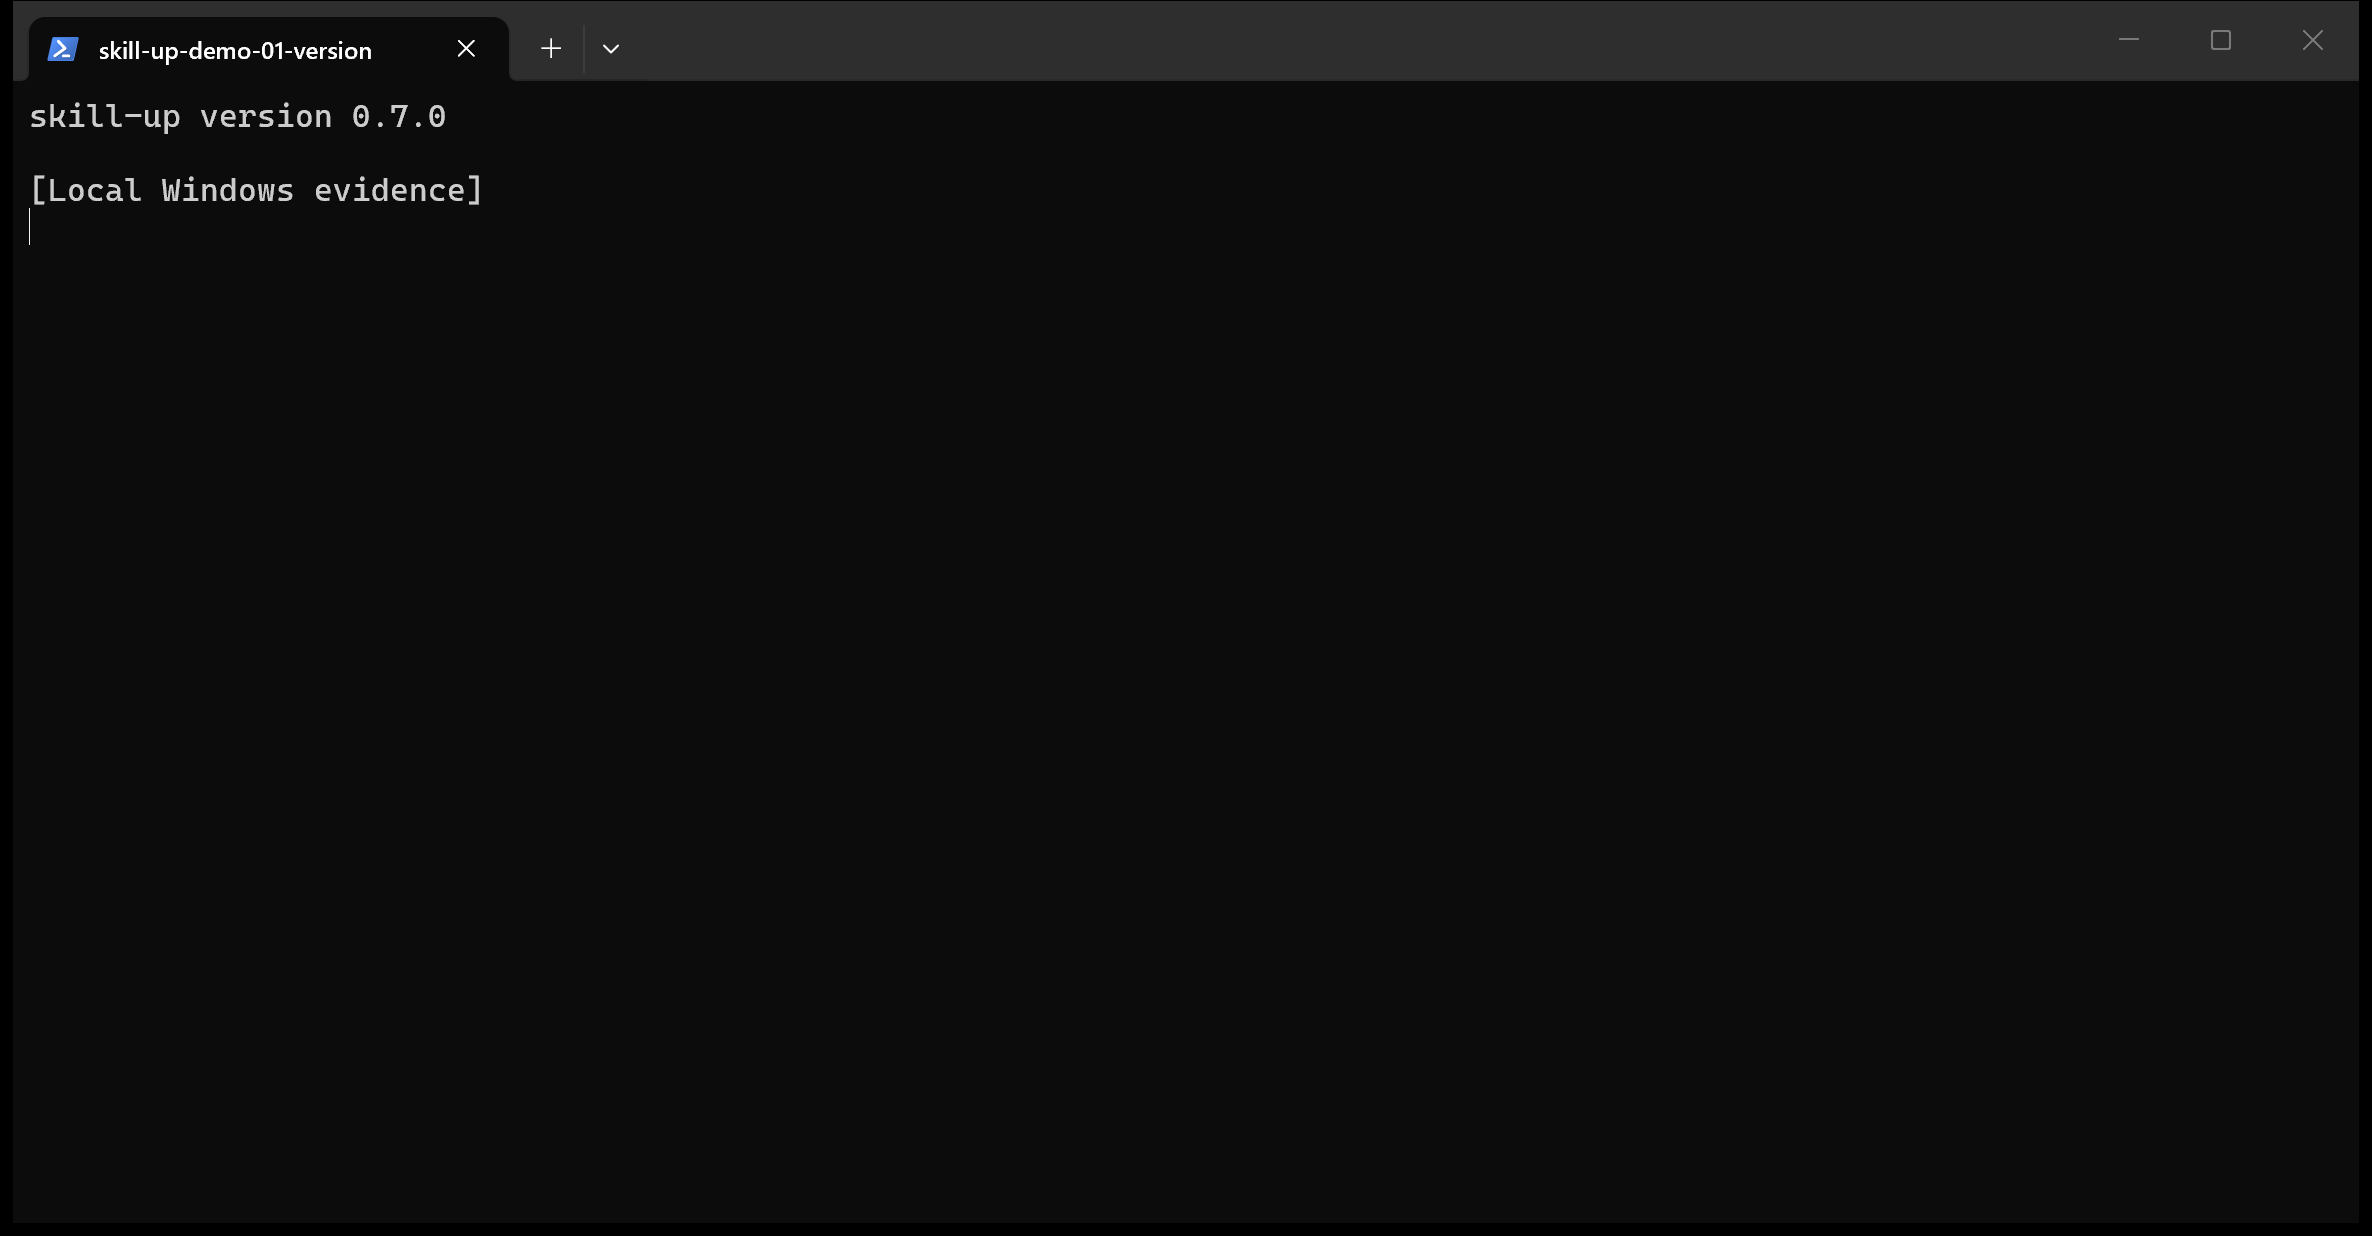
本机结果:skill-up version 0.7.0。版本不对就别往下走——字段语义会随版本变,先对齐再谈「为什么红」。
02 最小被测目录
skill-up-smoke/
  SKILL.md
  evals/
    eval.yaml
    cases/
      hello-world.yaml
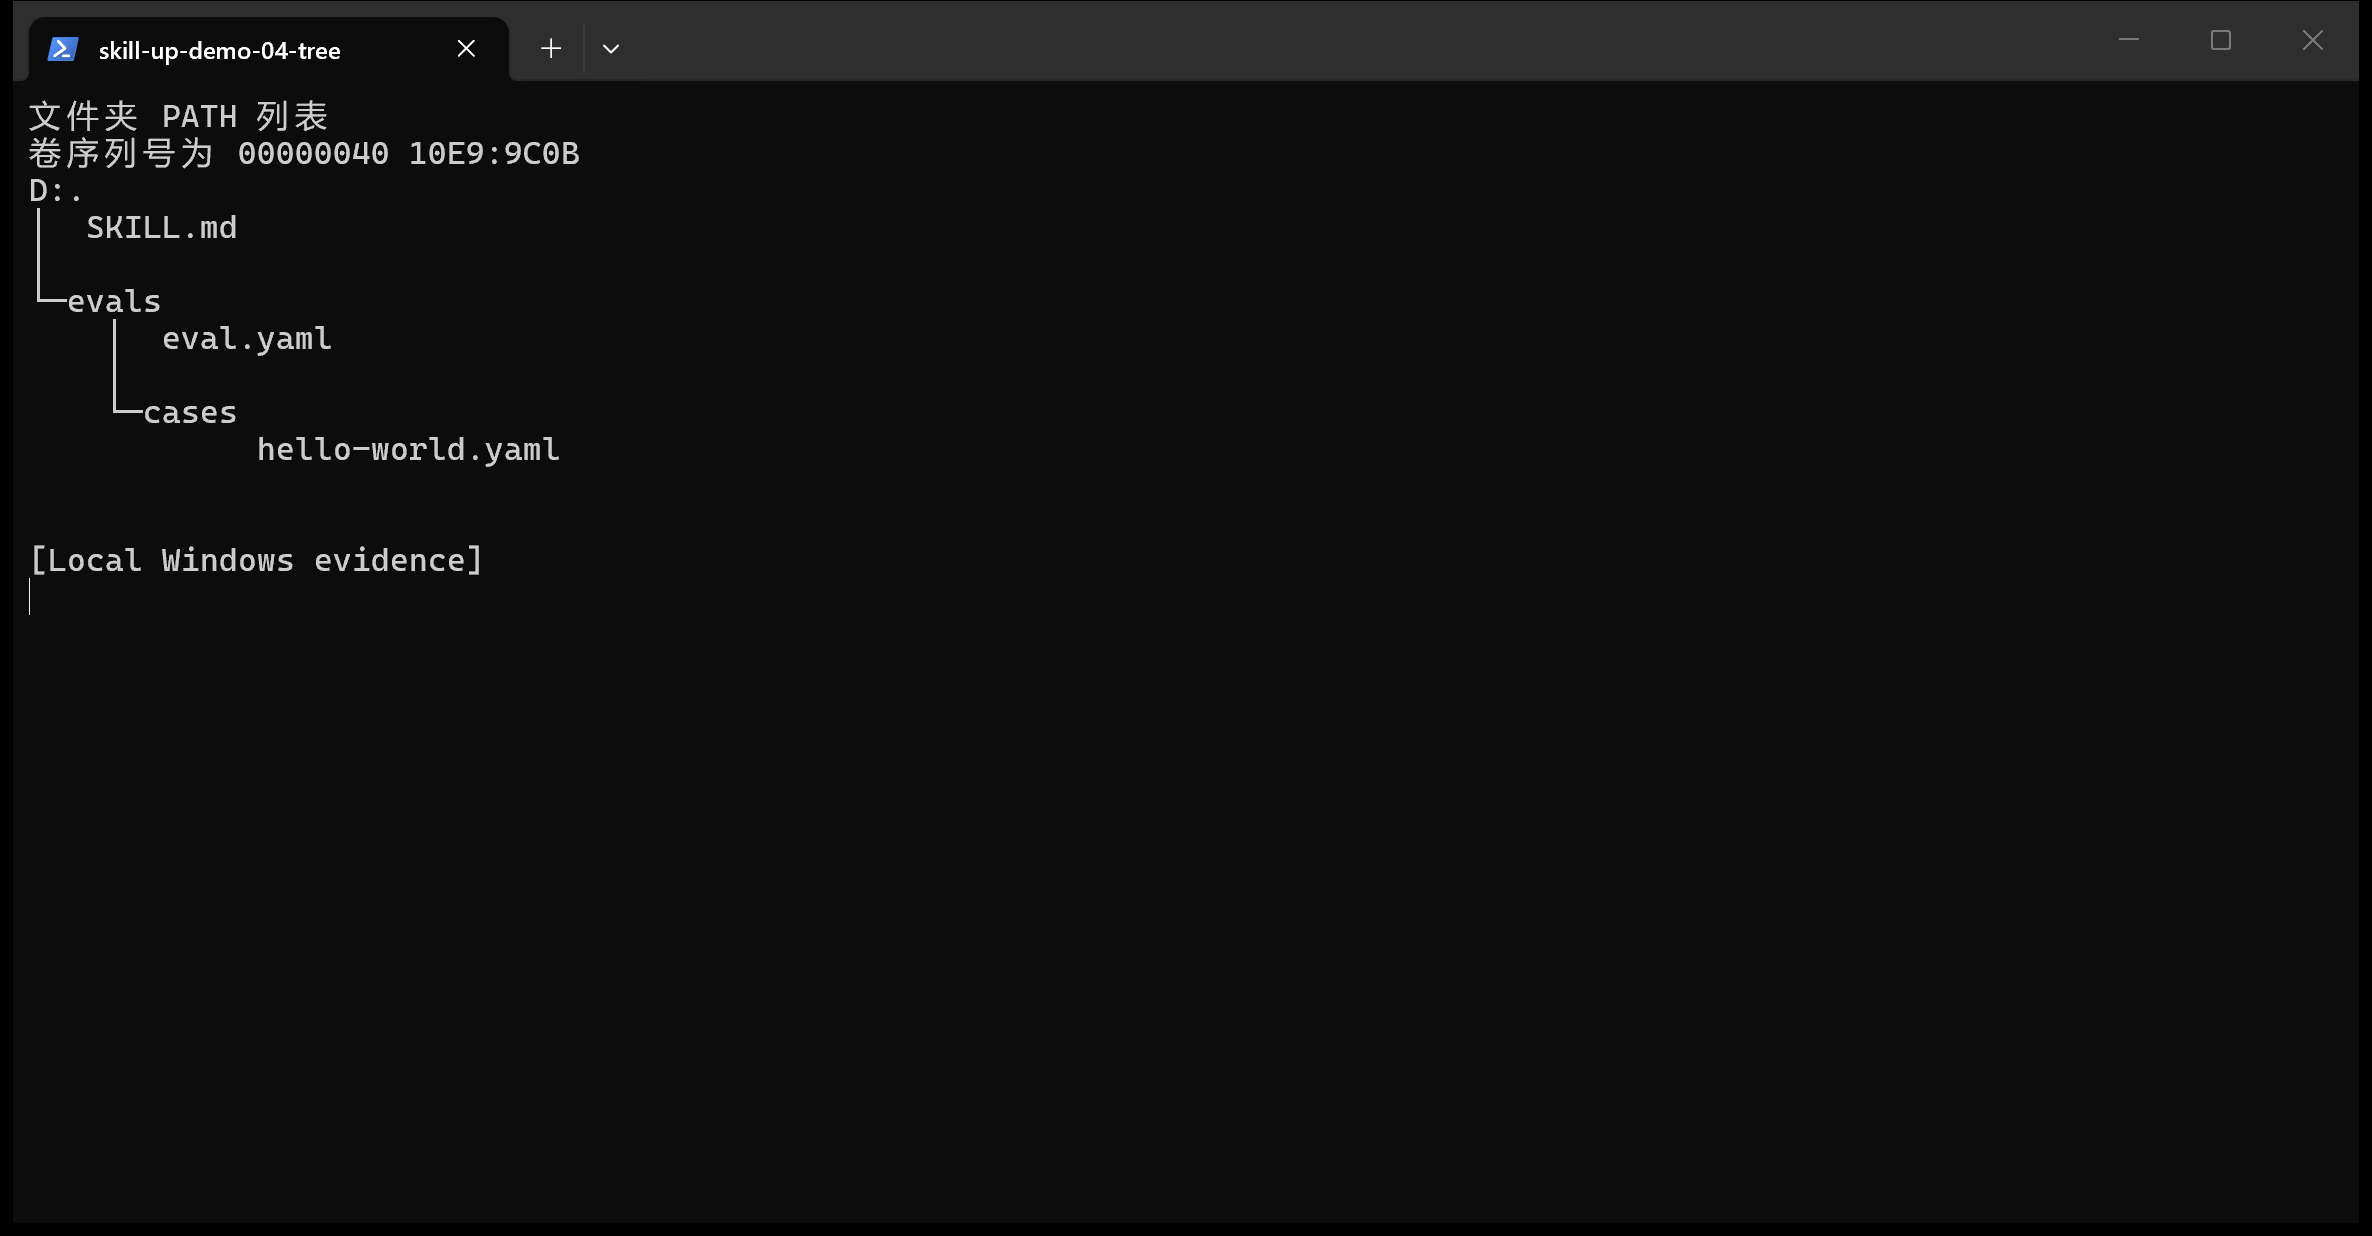
SKILL.md 只说明「被要求写 Hello World 时如何回答」——评测盯声明与行为,不是文采。对应场景:先守住最小预期,再谈文案优化。目录越短,评审越敢点开。
03–04 写声明与用例
evals/eval.yaml:
schema_version: v1alpha1
environment:
  type: none
engine:
  name: claude_code
cases:
  files:
    - evals/cases/hello-world.yaml
用例:
input:
  prompt: |
    请帮我生成一个 Hello World 程序
expect:
  must_contain:
    - "Hello"
    - "World"
只做 validate 时,引擎不必装好。must_contain 是本地确定性门槛,不烧 token——正好挡住「改描述把关键词搞没了」。
05 validate 必须先绿
skill-up validate
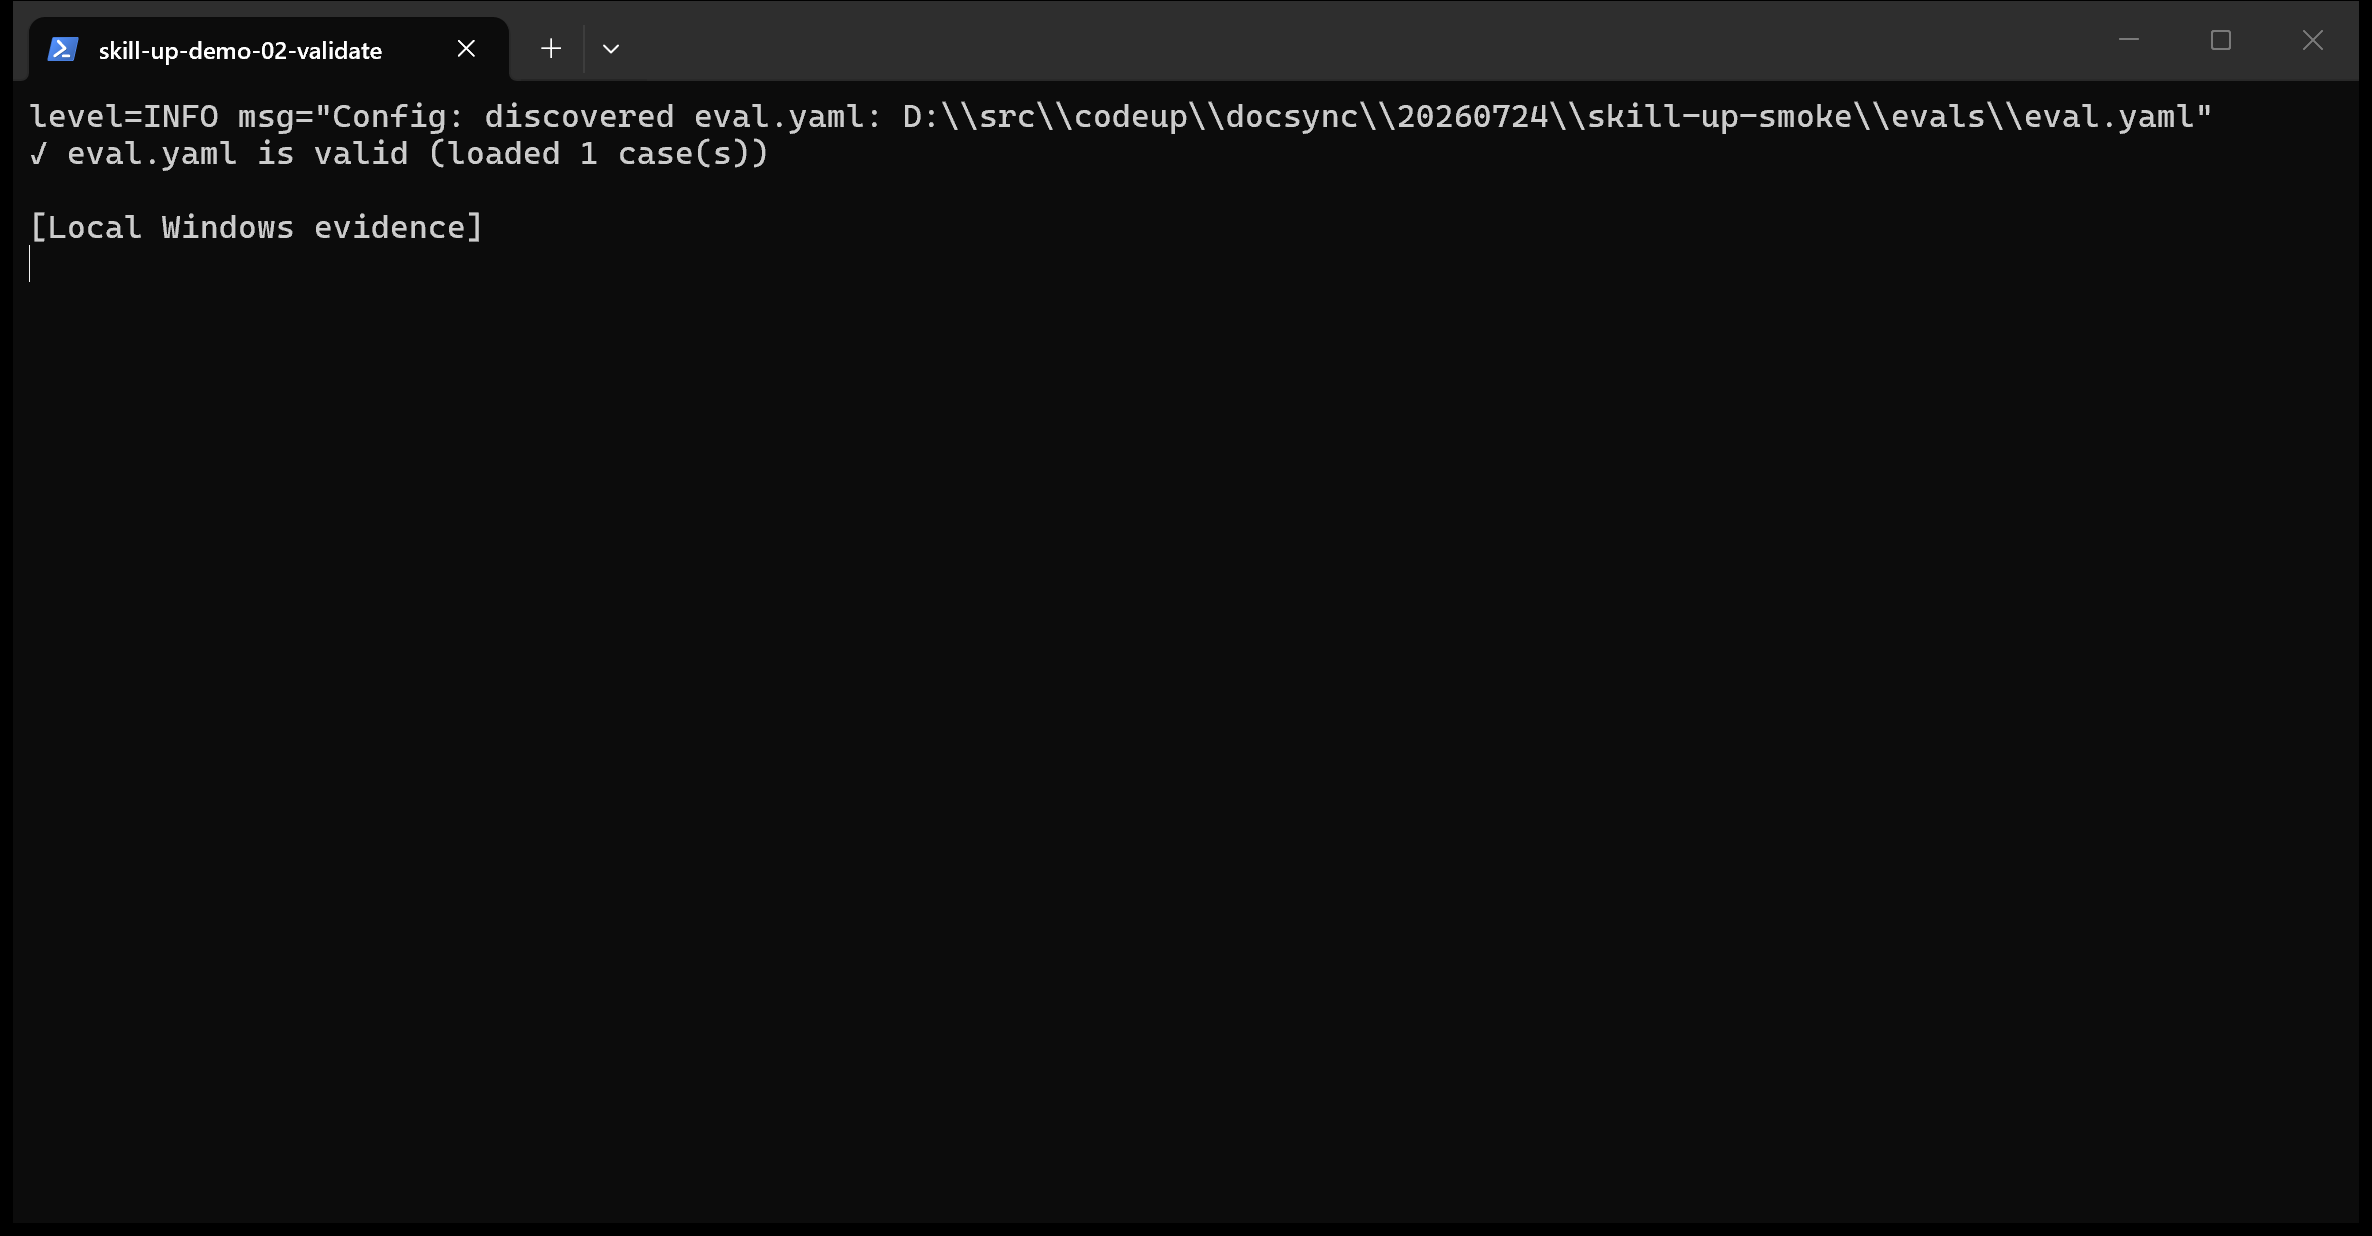
应看到 eval.yaml is valid (loaded 1 case(s))。这里红了,先修 YAML。对应场景:声明错误零成本暴露,别急着怪模型。这一步被低估了:很多「评测跑不起来」其实是引用错、字段写飘。
06 list-cases 核对读到的是你写的那份
skill-up list-cases
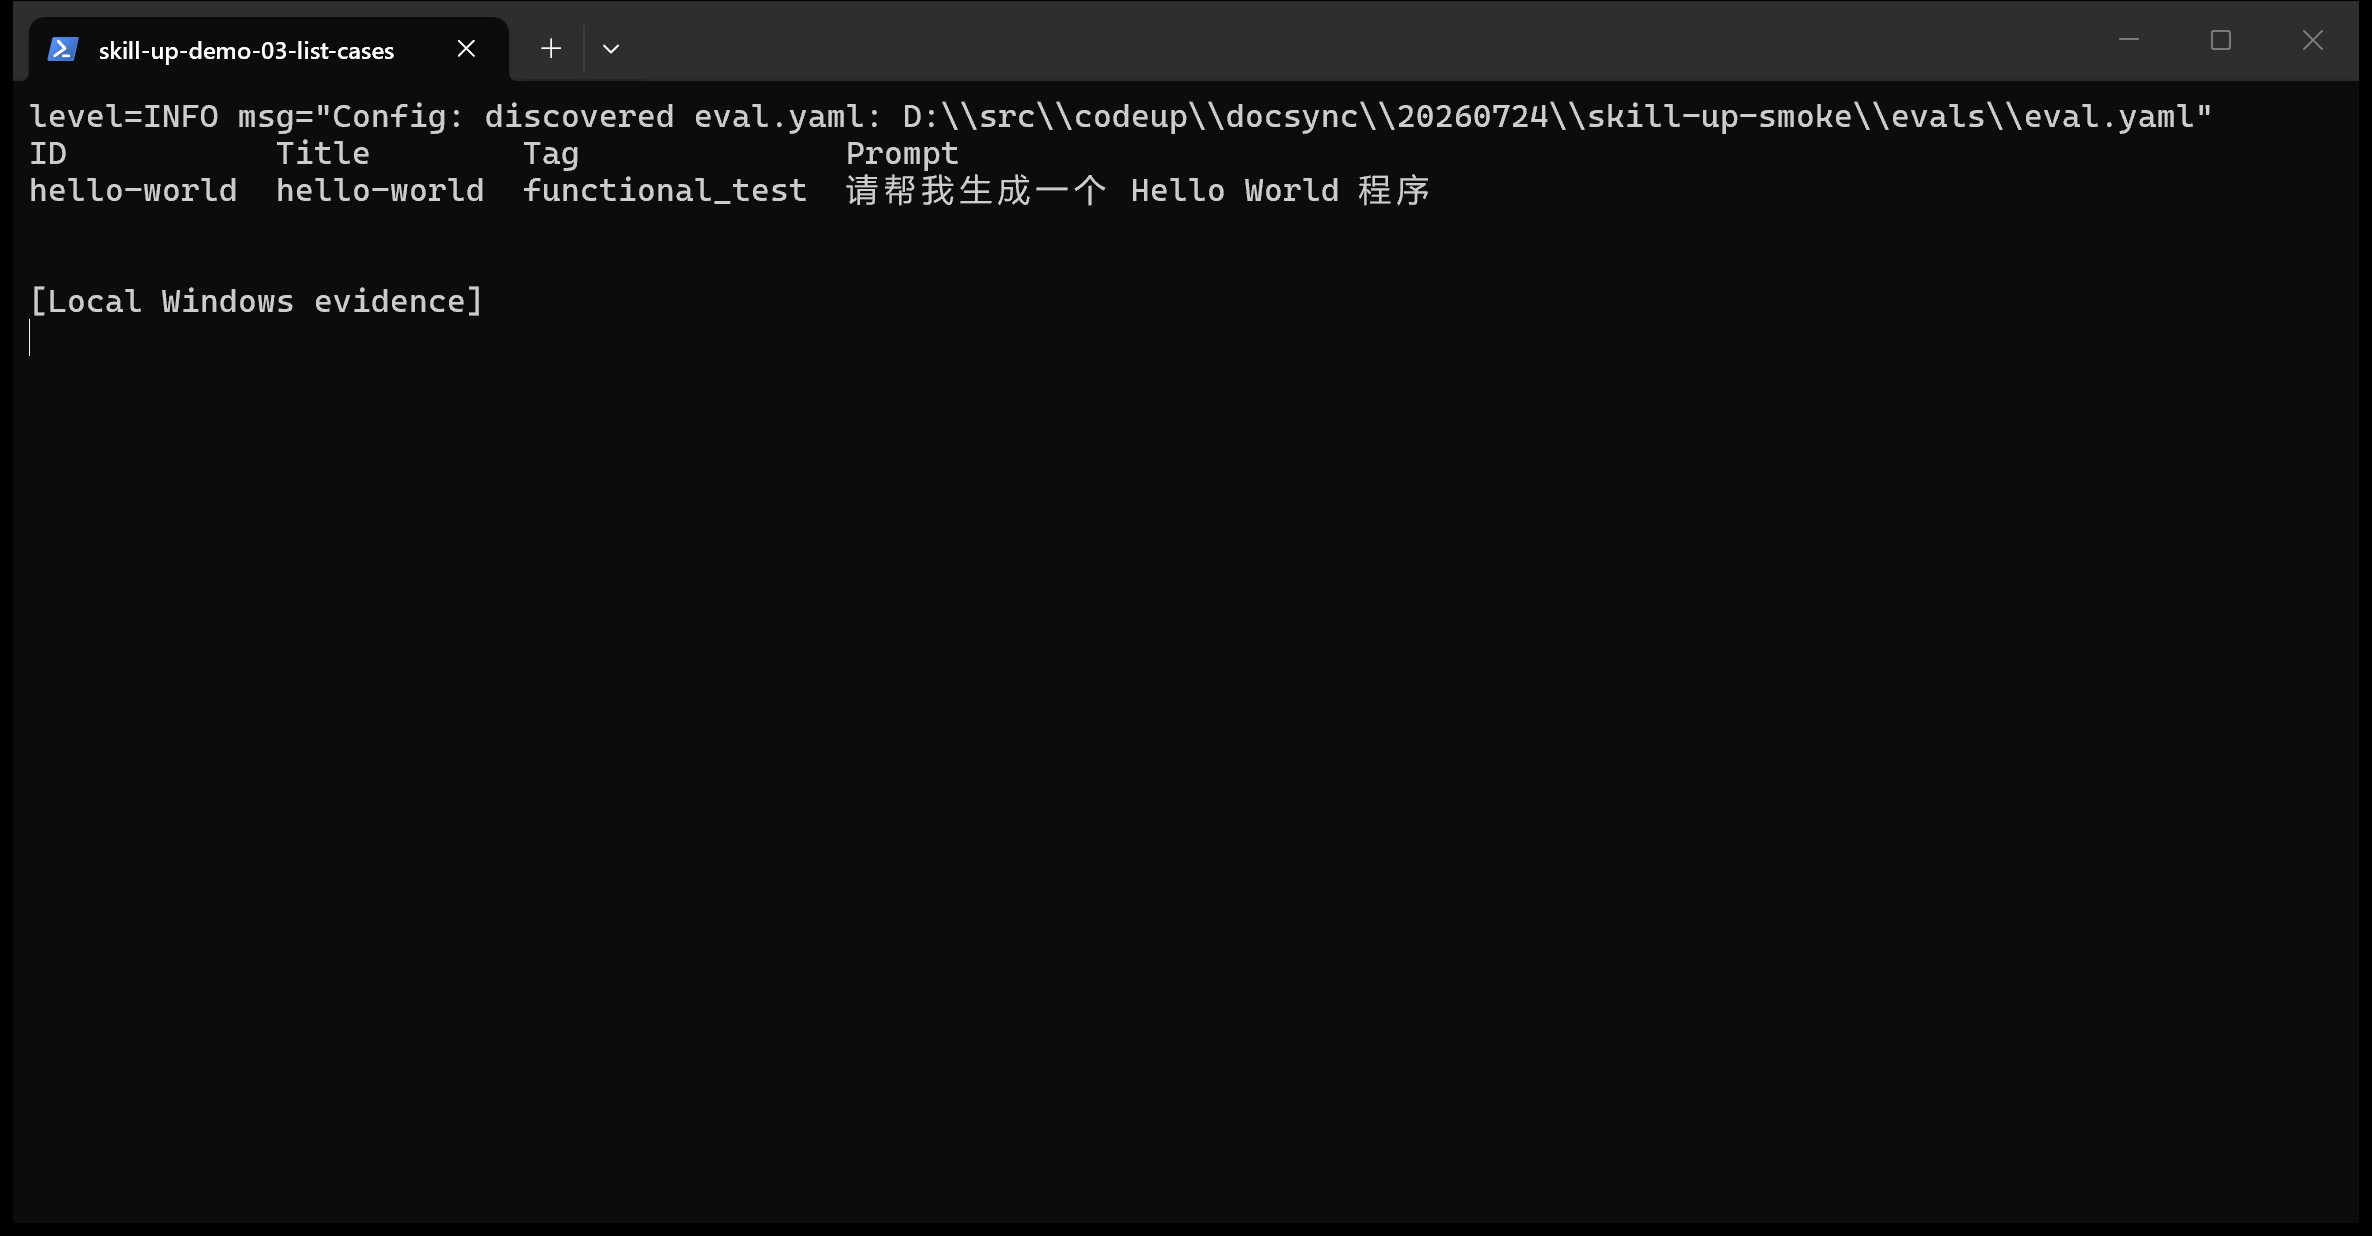
改了文件却 list 不到,是工作目录或 cases.files 指错——配置问题,不是「模型不够聪明」。老李见过太多排障会:一半时间在骂模型,一半时间发现路径写错了一层目录。
07 何时再 run
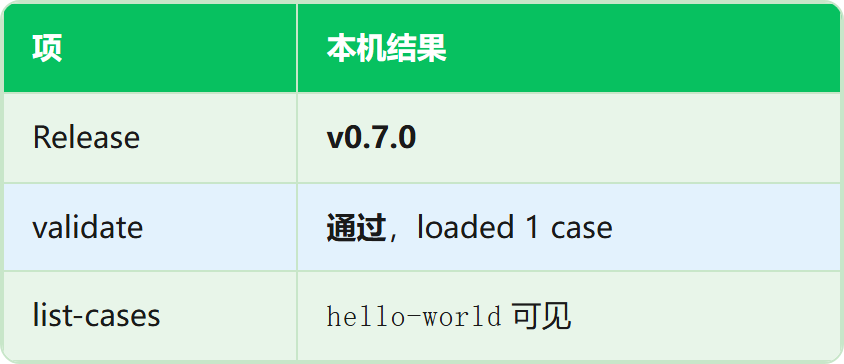
完整 run 要真实引擎与凭据。本稿实战终点:声明可验证已通。跑通后盯退出码与 HTML:退出码进 CI 才叫门禁。排障顺序:引擎/凭据 → expect 是否过严 → 最后才怀疑模型偶发。
06、洞见三条
洞见 01:预期不落盘,就等于没有门禁
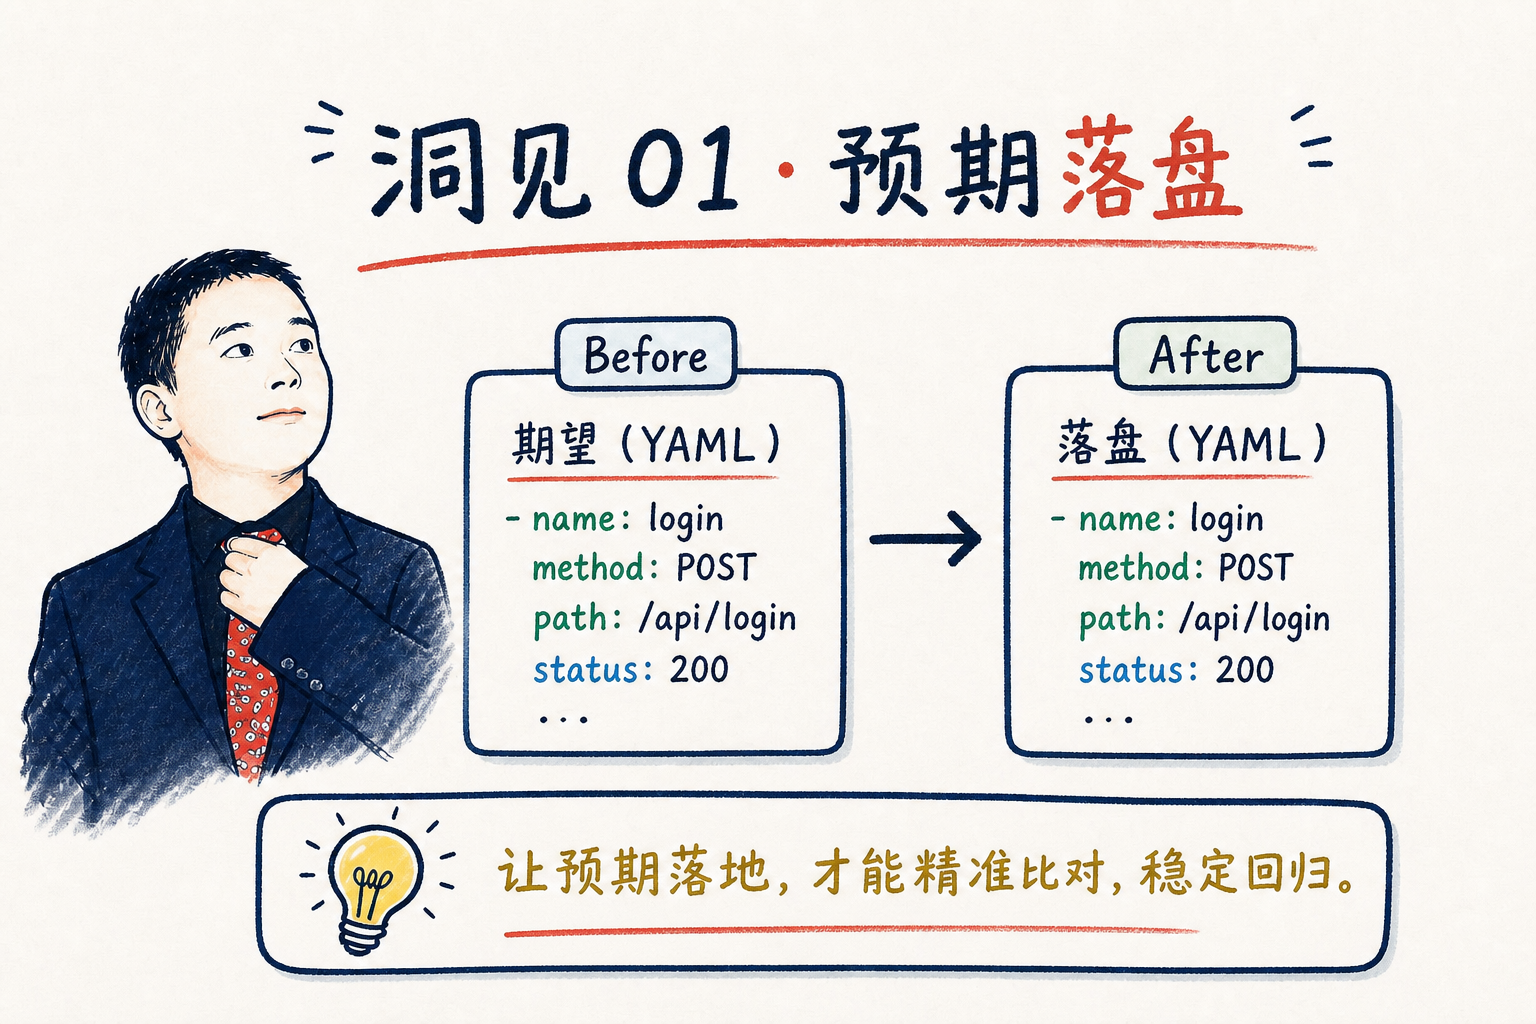
人脑里的「应该会调工具」,合并请求看不见。
YAML 固化之后,改预期必须解释——这比任何质量口号管用。
对同类问题:Prompt、脚本、Agent 流程,凡「靠感觉回归」的,先问能不能 diff。
洞见 02:先 validate,再烧 token
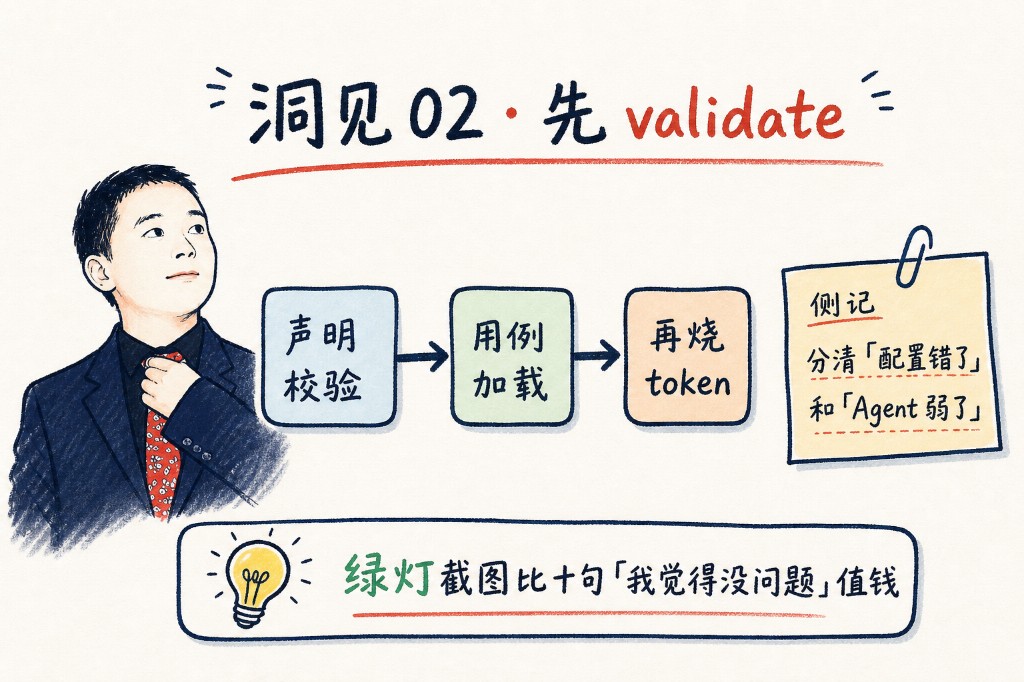
把「声明错了」和「Agent 弱了」揉进同一次失败,排障成本指数上升。
绿灯截图比十句「我觉得没问题」值钱。
对同类问题:先分配置故障与行为故障,再谈模型偶发。validate 是门禁第一道闸。
洞见 03:语义评审最怕被测侧学会表演
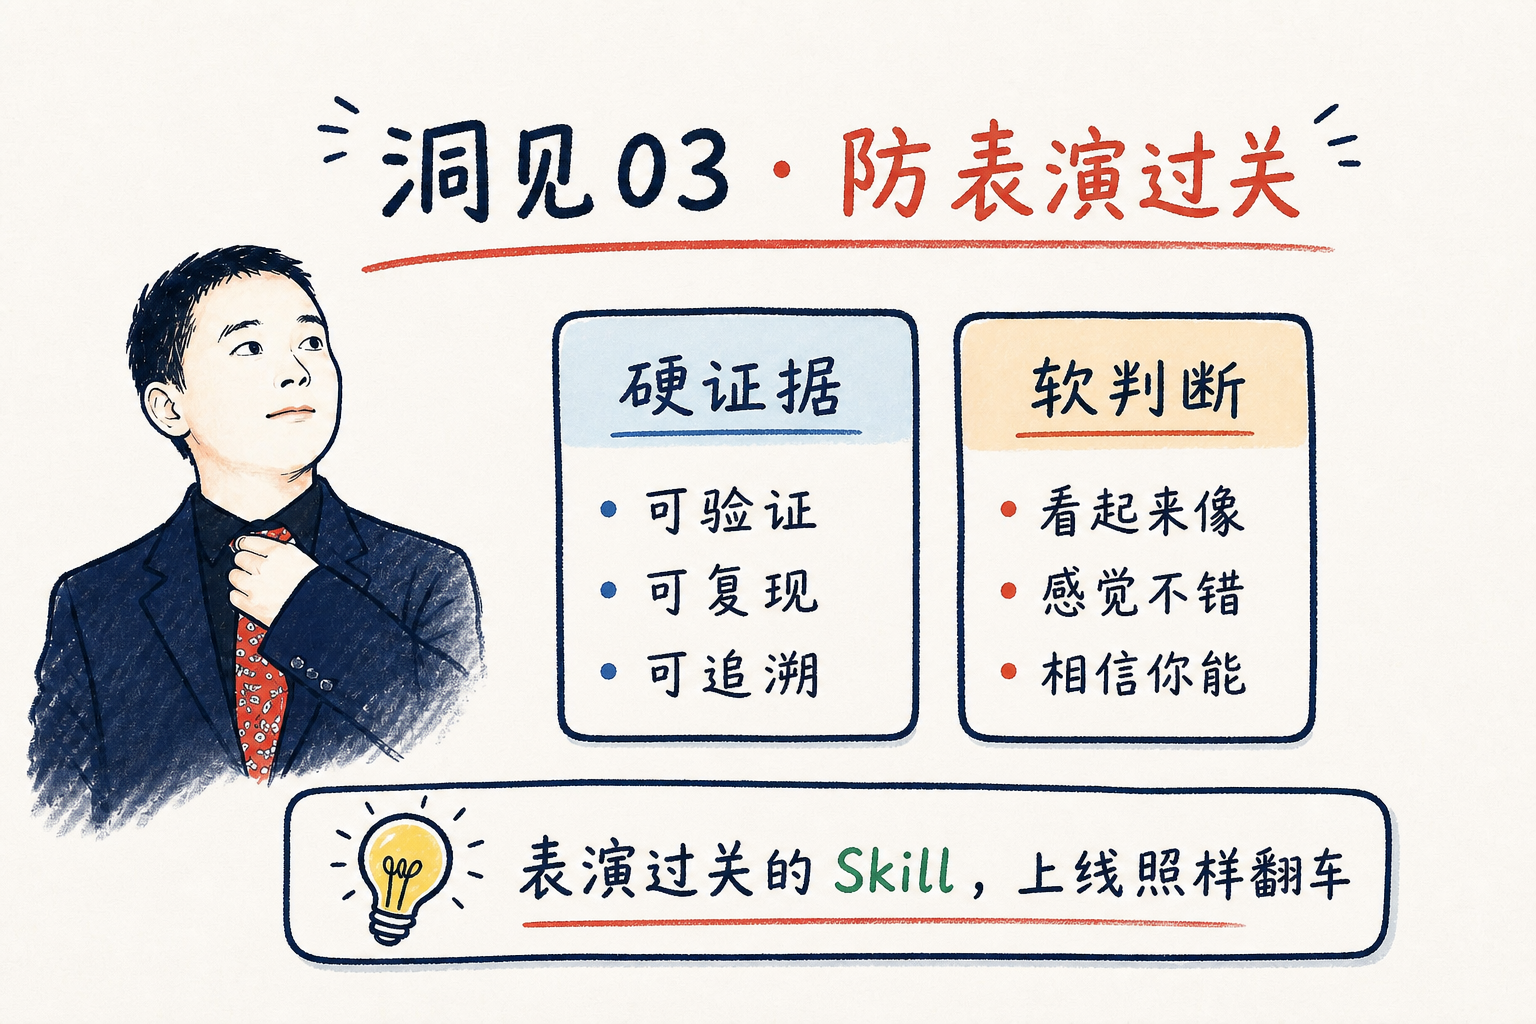
硬证据(脚本 diff)在前,软判断在后;评审能力只给评审侧。
表演过关的 Skill,上线照样翻车。
对同类问题:凡 LLM-as-judge,先问证据是否可复现、判题器是否与被测隔离。
07、行动拆解
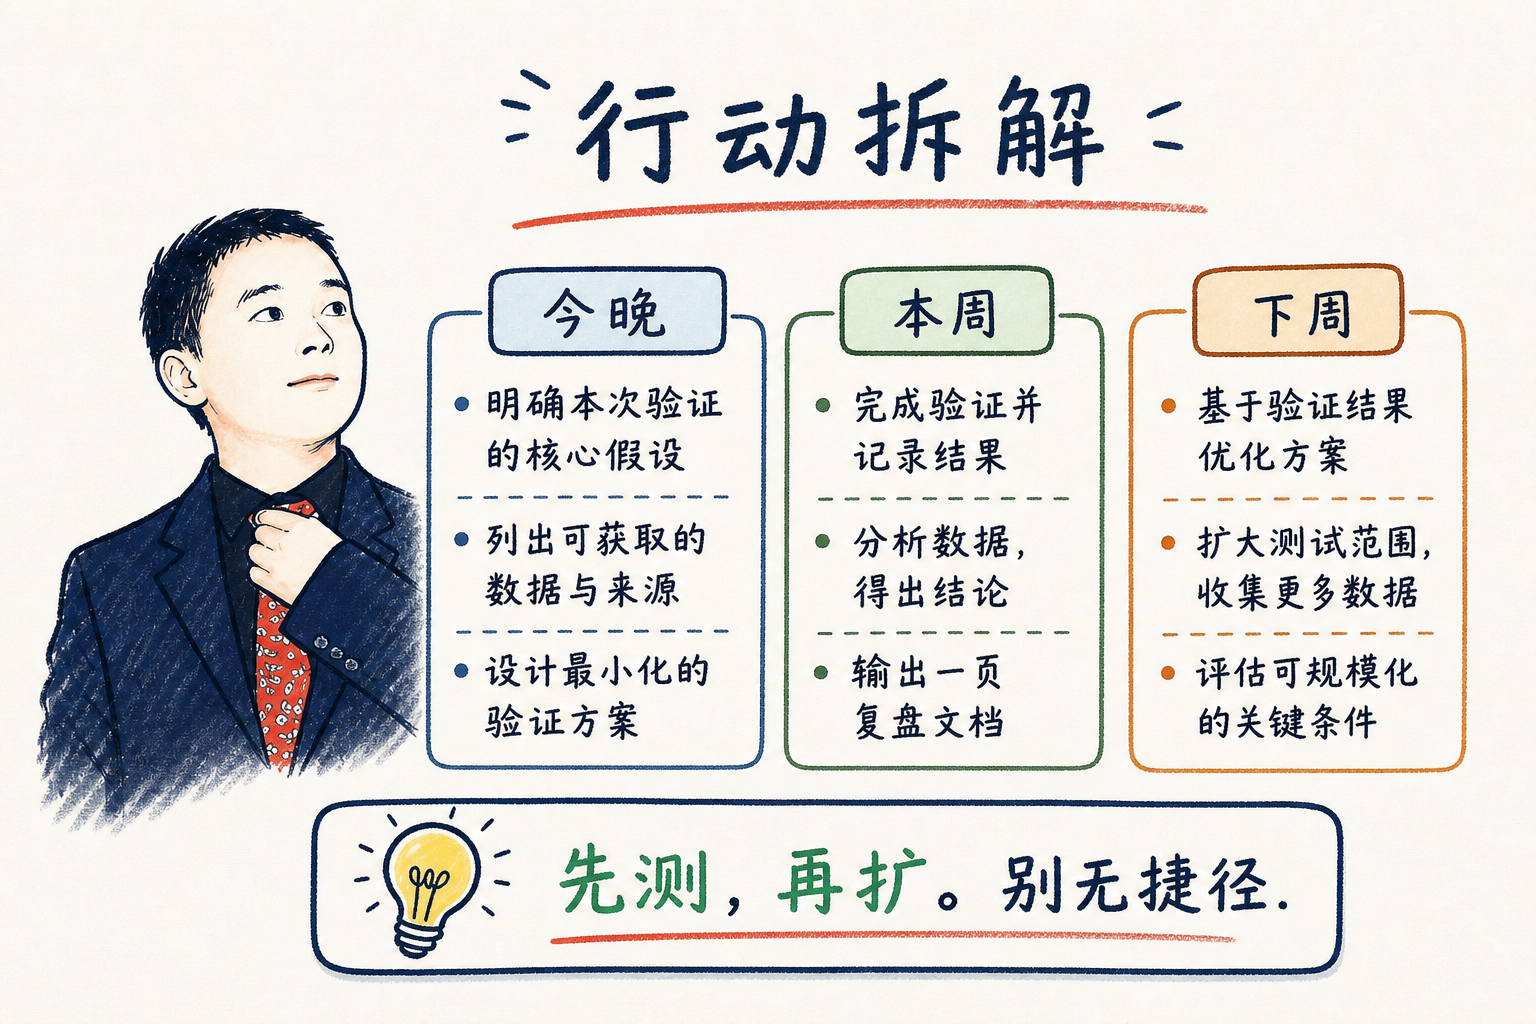
行动纲领:
- 落最小
evals/(先一条用例)。 - Windows 跑通
validate,绿屏进合并请求。 - 同一条声明进 CI:退出码非 0 即挡。
- 凭据就绪后再
run;重型用例走定时回归。 - 改描述前先看用例 diff——改预期就要说话。
- 复盘只讨论「哪条声明该拦住」,不讨论「模型今天状态不好」。
08、小结
Skill 能跑,只说明它会说话;Skill 能测,才说明它还听话。
从周五那次「友好措辞」事故往回看:缺的不是更多聊天,是更早的声明与更硬的退出码。skill-up 把评测从私货脚本,拉回团队可读的资产。集团侧有过约 1200 行手搓评测迁成声明的案例——迁移完成后,评测才变成可读资产。
今晚就能做完的事,别拖到「下周质量专项」。先测,再扩。别无捷径。
09、链接与概念说明
本节约归纳文中出现的链接与术语,便于对照;无配图。
- skill-up:阿里开源的 Agent Skill 声明式评测 CLI;本文实跑 v0.7.0(Windows amd64)。
- 用户手册(中文):安装、配置、用例与引擎说明的官方文档入口。
- Releases:二进制发布页;Windows 取
windows_amd64包。 - Agent Skill:面向 Agent 的说明文件 + 脚本/工具配置组合;行为对措辞与引擎敏感。
evals/eval.yaml:评测总声明(环境、引擎、用例列表等)。evals/cases/*.yaml:单条用例(输入 prompt 与 expect/judge 等预期)。validate:校验声明是否合法、用例能否加载;不跑完整 Agent。list-cases:列出框架读到的用例,用于核对路径与内容。run:拉起真实引擎回放用例;需本机 CLI 与模型凭据。expect:本地确定性断言(如 must_contain),零/低成本。judge:规则/脚本/语义评审等更深判定,按需启用。- 退出码:进程返回码;
0通常表示全部通过,适合做 CI 门禁。